
AI 工作實務 · 資料重算/分母診斷
報表的空白不是 0:缺漏資料如何讓平均值與績效判斷失真?
先分辨零值、缺漏與不適用;揭露覆蓋率、按來源排查,再計算相符的平均數

本文目錄
先把 3 個容易混淆的狀態分開12 筆案例:同一份資料得出 2 個平均值三種處理方式,分別可回答哪些問題?管理報告如何寫,才不會讓主管誤判?把做法變成固定的 5 個欄位可直接使用的工具來源與限制圖片與素材說明客服報表有 12 筆案件,其中 4 筆「處理分鐘數」空白。若全部當成 0,平均處理時間為 6.67 分鐘;若只計有紀錄的 8 筆,則為 10 分鐘。兩個數字算術上都可重現,卻回答不同問題。真正的第一步不是決定要填 0 還是刪除,而是查明空白從哪裡來,以及報告要代表哪一群案件。
這篇示範如何用一份 12 筆合成教材,建立「狀態定義 → 缺漏診斷 → 三種計算 → 報告結論」的檢核程序。讀者可直接下載 CSV,套到客服、行政、工單或管理報表。所有數字皆為教學假設,非天地人或客戶營運實績。
先把 3 個容易混淆的狀態分開
「0」、「沒有資料」與「不適用」在業務上並非同義。
| 狀態 | 資料值 | 合理情境 | 報表規則 |
|---|---|---|---|
| 已量測且結果為 0 | 0 | 系統在同一分鐘內完成處理,計量精度為整數分鐘 | 是有效觀測值,計入分母 |
| 應有資料但缺漏 | 空白或 NA | 人工組尚未回填結束時間 | 列為缺漏,不擅自變成 0 |
| 根本不適用 | 不適用 | 沒有人工處理的純通知案件 | 從這項指標的母體定義排除,但仍要有排除理由 |
pandas 官方文件將 NA 視為「未知」,常見平均等彙總計算會略過缺漏;Microsoft Power Query 則提供填滿空值的資料處理動作。兩者都只是軟體行為,不能替企業決定業務上應填多少。S01S02 英國國家統計局將資料缺漏與資料覆蓋誤差區分,也提醒任何插補方法都帶有模型假設。S03
因此,先定義欄位、再定義分母,最後才選計算方法。
12 筆案例:同一份資料得出 2 個平均值
假設有甲、乙兩組客服案件,處理時間單位為「分鐘」,皆為已結案的案件。甲組 6 筆都有紀錄:12、10、8、15、9、14。乙組 6 筆只有 2 筆有紀錄:12、0;另 4 筆缺漏。來源為本篇自製 case_missingness.csv。
- 甲組合計 68 分鐘,6/6 筆有效,觀測平均約 11.33 分鐘。
- 乙組合計 12 分鐘,只有 2/6 筆有效,觀測平均 6 分鐘。它不是乙組全部案件的真實平均。
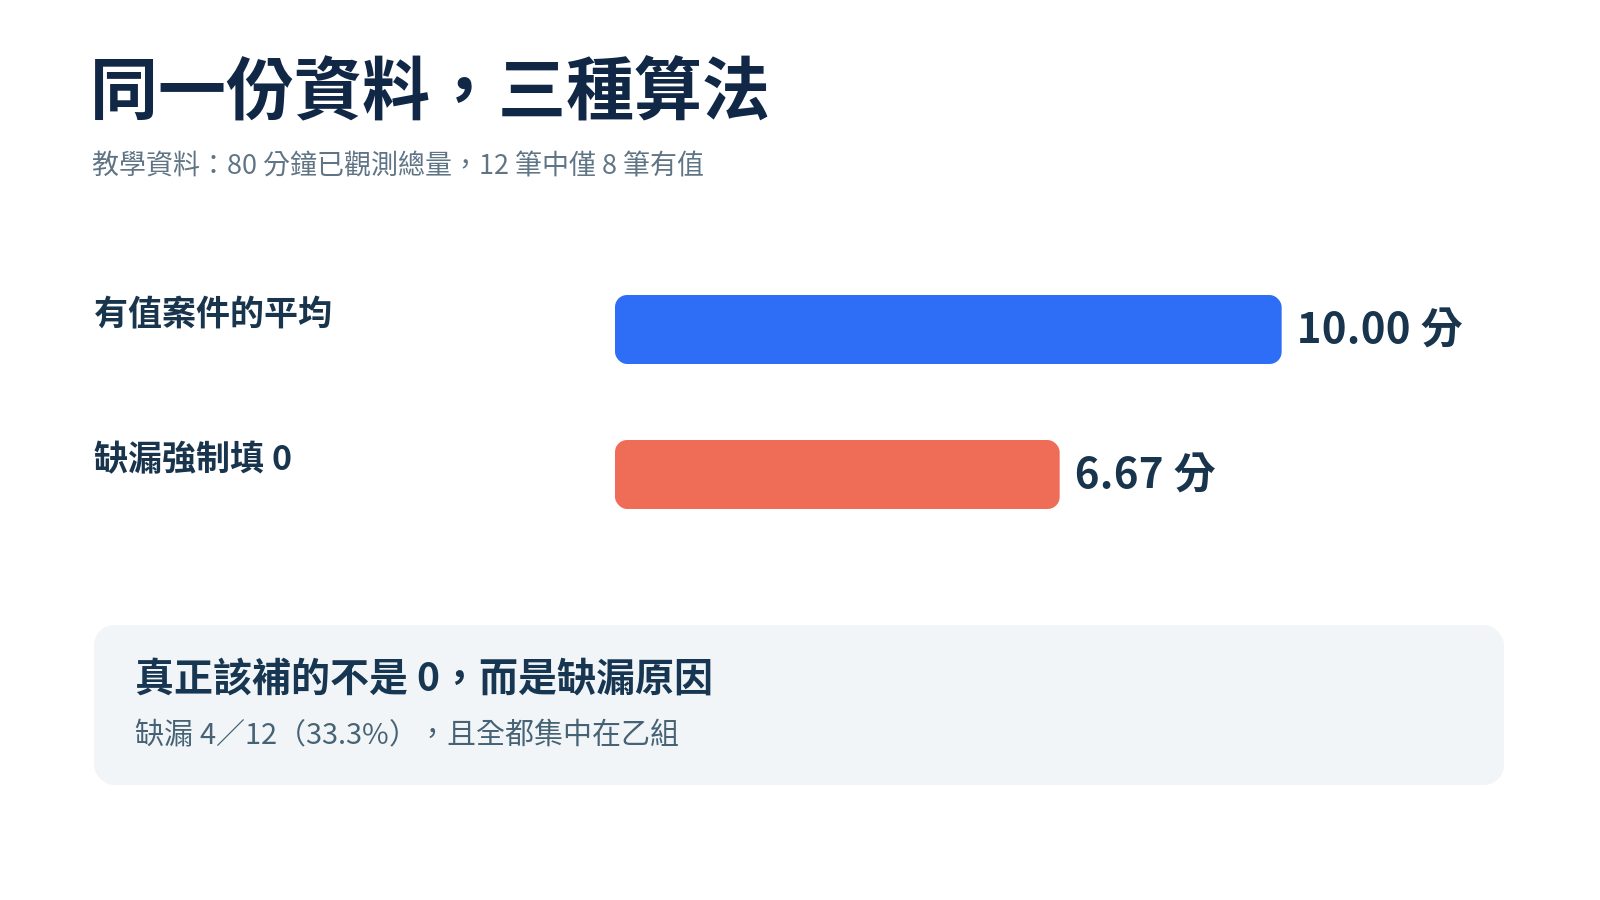
- 全部 12 筆合計已觀測 80 分鐘。只算有效 8 筆,平均 10 分鐘。
- 強制將 4 筆缺漏填成 0,變成 80 ÷ 12 = 6.67 分鐘,比有效樣本平均低約 33.3%。
這個差距不是公司真的變快了,而是「分母由 8 變成 12」的算式結果。請同時顯示有效筆數、應有筆數與缺漏率。本例缺漏率為 4/12=33.3%;更重要的是,4 筆缺漏全部集中在乙組,不能把兩組當成紀錄品質相同。
三種處理方式,分別可回答哪些問題?
| 方法 | 本例結果 | 何時可用 | 不可偷換的結論 |
|---|---|---|---|
| 略過缺漏,僅算有值紀錄 | 10.00 分鐘 | 要描述已量測案例;同時揭露 8/12 覆蓋率 | 不得稱為全部 12 筆的平均 |
| 缺漏一律以 0 代替 | 6.67 分鐘 | 只有確認空白代表實際零分鐘時 | 不得把技術性空值直接視為業務零值 |
| 缺漏另列、暫不估計整體平均 | 本例不填單一全體值 | 缺漏集中於特定組別,尚無補填依據 | 不可在 KPI 頁偷偷刪掉缺漏率 |
若有獨立可驗證的業務規則,例如系統只在 0 分鐘時留白,才可把該類空白重編為 0,而且要記錄規則、適用期間及版本。如果已確認缺漏發生於人工組,應優先補採原始結束時間,或至少獨立公布「甲組有值 6/6、乙組有值 2/6」。
資料插補可以是後續分析方法,但其假設應由分析者解釋,不能用「工具有補值按鈕」取代論證。S03
管理報告如何寫,才不會讓主管誤判?
不建議:「本週案件平均處理時間為 6.67 分鐘,效率改善。」
較可辯護的寫法:「本週 12 筆已結案案件中,8 筆有完整處理分鐘數;這 8 筆的平均為 10 分鐘,覆蓋率 66.7%。另有 4 筆缺漏且均屬乙組,尚不能推論全部案件的平均耗時;預計由乙組負責人核對結束時間後再產出全體 KPI。」
該段同時提供結果、分母、偏差線索和待補證據,避免把缺漏當成業績變動。
把做法變成固定的 5 個欄位
拿下載的 missingness_audit_blank.csv 開始,逐欄填入:指標/應有母體/有效值定義/缺漏來源/處理與揭露規則。不要先把所有 Excel 空格全域取代為 0。之後另建異常明細,至少記錄來源系統、負責人、待補時間與重算批次。
驗收不只看平均值有沒有算出來,而是逐一檢查:資料列數是否一致?0 是否仍保留?空字串和「不適用」有沒有誤併?各組覆蓋率能否單獨重算?報告是否揭露分母與排除條件?
一旦數值會用來評估個別員工表現或薪酬,這份教材不能直接作為考核結論,必須先核實資料蒐集口徑、員工工作分派差異與相關制度。
可直接使用的工具
延伸閱讀:站內 AI 合併 Excel 時的重複與漏配驗證 針對資料合併;本篇針對缺漏值及平均數分母。若需練習清理、分群與 Dashboard,可查看 AI 數據分析與視覺化課程的現行課綱與報名資訊。實際場次、費用與報名方式以課程頁為準。
來源與限制
[S01] pandas 官方文件〈Working with missing data〉:https://pandas.pydata.org/pandas-docs/stable/user_guide/missing_data.html
[S02] Microsoft Learn〈Fill values in a column〉:https://learn.microsoft.com/en-us/power-query/fill-values-column
[S03] 英國國家統計局 ONS〈Cataloguing errors in administrative and alternative data sources〉:https://www.ons.gov.uk/methodology/methodologicalpublications/generalmethodology/onsworkingpaperseries/cataloguingerrorsinadministrativeandalternativedatasourceswhatwhenandhow
本文計算來自合成案例的可重算資料,不是對實際資料集的鑑證。
圖片與素材說明
封面:黑色背景的觀測分布抽象圖,四個未回填記錄另外標示,彩色圈大小不對應資料數量。(教學概念或合成資料示例)
本文由 TARAISG(TIANDIREN AI SOLUTION GROUP)使用 AI 模型產生正文、整理來源並設計實務工具。方法依據與限制列於文末;案例為明確標示的教學假設。未有具名紀錄時,不宣稱經人工或專家審核。
查看內容製作與更正說明



