
AI 工作實務 · 產品解析・資料擷取與企業試點
Cloudflare Clairic 是什麼?資料擷取模型的價格、API 用法與企業導入限制
Clairic 如何把文件轉成可驗證的欄位?從官方模型規格、測試數據與 API 示例,理解企業資料擷取的工作分工、成本與導入限制。

本文目錄
一、先辨別:Clairic 是什麼,不是什麼?二、Clairic 究竟能處理哪些資料?九種型別背後的四類任務三、System One 不是「比較笨的 LLM」,而是不同的計算設計四、Cloudflare 公布的效能數字,應如何正確閱讀?五、0.10 美元的定價為什麼值得注意?先把帳算對六、企業可以拿 Clairic 做什麼?五個值得試行、也要知道限制的場景七、它和 OCR、規則引擎、LLM Structured Outputs 有什麼不同?八、從官方 API 範例看實作:先做一個不會付款的安全 Demo九、企業級架構:不要讓模型直接成為付款權限延伸實作:把準確率量成可以決策的證據,而不是一個漂亮百分比延伸實作:一個 4 週試點應交出哪些具體成果?延伸分析:Clairic、AI Agent 與企業權限的真正關係十、Clairic 的真正影響:企業 AI 將從「模型中心」走向「任務中心」十一、管理者可以直接採用的決策清單常見問題 FAQ下一步:真正值得導入的,不一定是最新的模型來源與查核說明圖片與素材說明2026 年 10 月 21 日|天地人文創研究編輯|產品與技術資訊查核截至 2026 年 10 月 21 日。本文將官方公布、供應商測試與編輯分析分別標記,不代表已在企業真實環境完成驗證。
一封客訴信進入企業,真正需要被理解的,可能只有五件事:訂單編號、損壞商品、申請金額、保固狀態與下一步處理期限。企業卻常把整封信送進大型語言模型,請它讀完、思考,再寫一段 JSON 回來。表面上只是資料處理;在背後,每個步驟都動用了原本擅長寫作、摘要與推理的生成式模型。
Cloudflare 於 2026 年 10 月 19 日推出預覽版 Clairic,質疑的正是這種工作分配。倘若任務是把資料轉成可使用的數字、日期和清單,AI 是否需要先「寫」出答案?Clairic 將輸入資料與欄位規格直接映射為型別化結果,試圖讓擷取、簡單計算、估算與短期預測成為獨立的模型工作,而不是每件事都由同一個大型語言模型承擔。S1S2
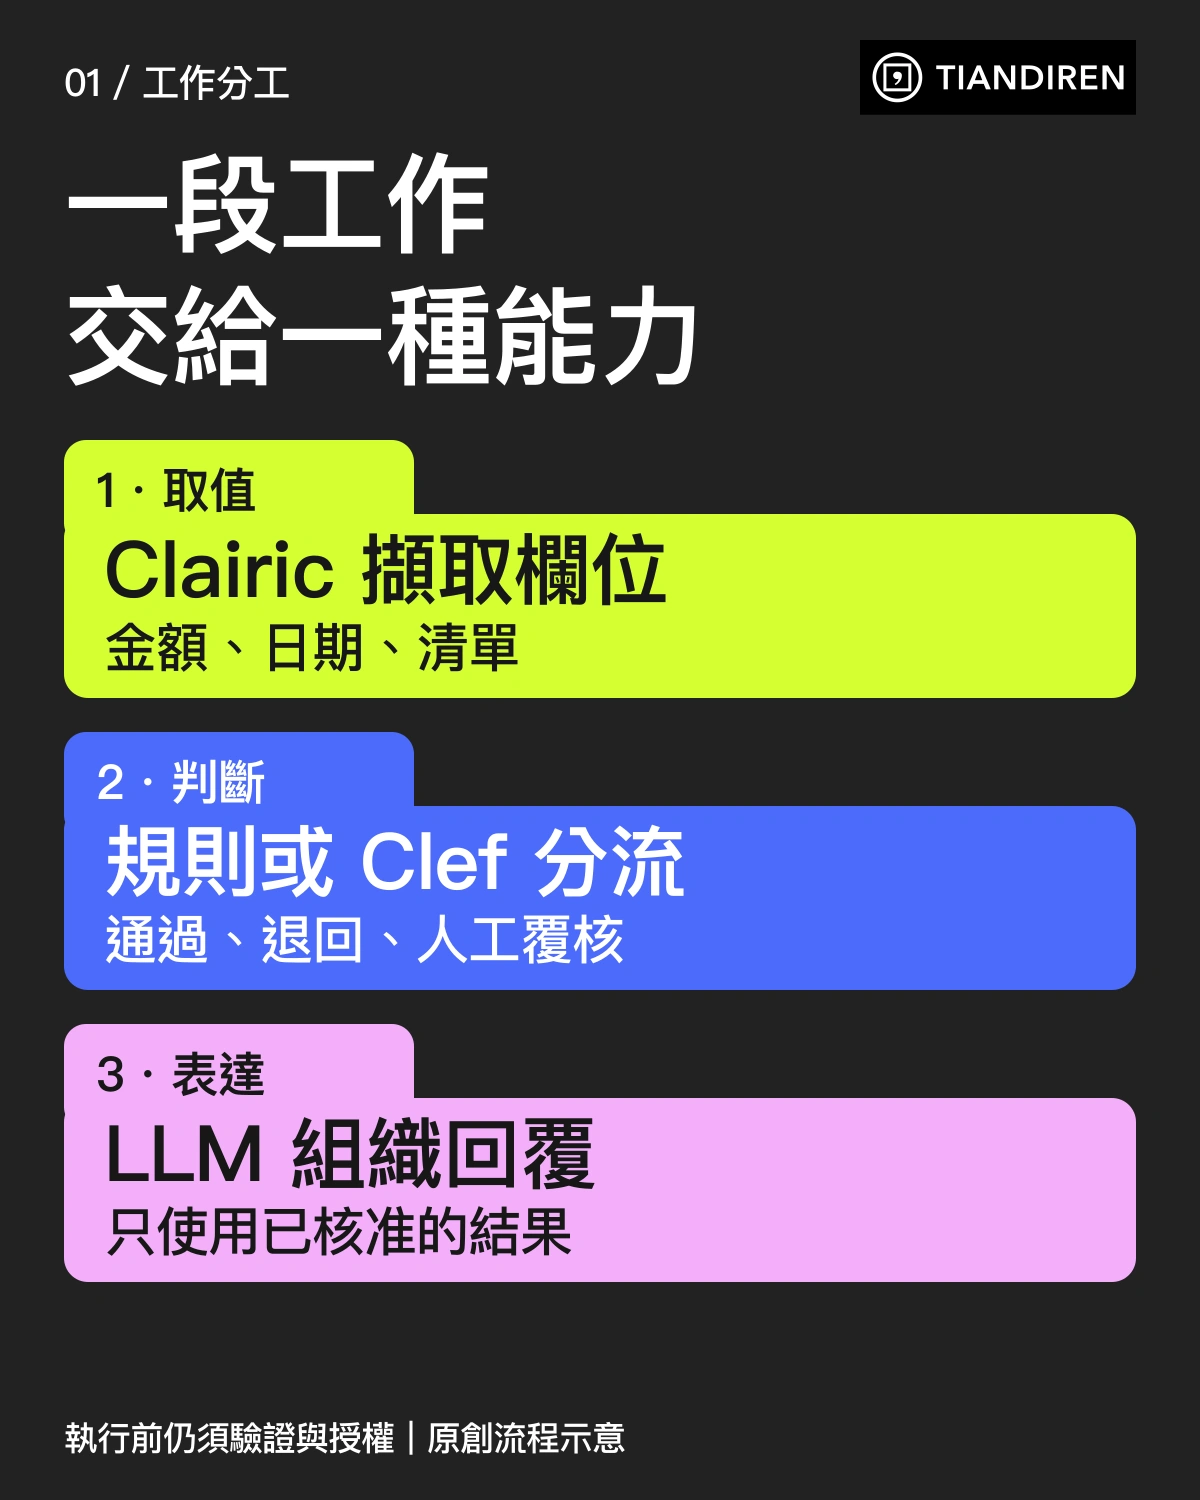
這不只是又一款便宜的 AI。真正值得企業理解的是:把「知道事實」「決定怎麼做」「向人解釋」拆成三個不同的問題,讓每個問題由最適合的工具解決。當 AI Agent 開始連接財務、採購、客服與業務流程,這種責任分離也許比單一模型的效能排行榜更重要。
一、先辨別:Clairic 是什麼,不是什麼?
Clairic 的官方模型識別名稱是 @cf/cloudflare/clairic,目前以預覽(Preview)型態提供於 Cloudflare Workers AI。官方將它稱為「System One」風格的 Extraction Model。使用者提供 state,也就是要讀取的文字或情境資料,再提供 fields,指定所需欄位與資料型別。模型輸出一組結構化答案,不需要以文字逐字生成回覆。S2S3
例如,一張發票記載:「2026 年 9 月 2 日開立,運費 80 美元,4 個棧板,每個 250 美元,付款條件 30 天。」一般 LLM 可能先生成敘述:「總金額為 1,080 美元,付款日為 10 月 2 日。」Clairic 的設計則是讓應用程式直接請求 total 作為 number、due_date 作為 date。下游程式拿到型別化的結果,就可以驗證、比對、入帳或交給人員覆核。這是依 Cloudflare 官方教學資料改寫的中文示例,不是天地人實際測試的交易紀錄。S3
它不適合代替一般聊天模型回答開放性問題,也不能被視為能理解所有企業規則的決策引擎。換句話說,Clairic 擅長回答「這裡的金額是多少」,而不是獨自回答「公司應不應該付款」。後者還需要採購規則、授權條件、核准程序與可追溯的責任。官方也明確區分:Extraction Model 用於取值,Decision Model 用於在預設選項中做決定,Generative Model 用於產生說明文字。S4
一張表看懂三種 AI 的分工
| 任務 | 更合適的能力 | 輸出示例 | 企業仍需承擔的責任 |
|---|---|---|---|
| 從帳單找出應付金額與到期日 | Clairic 類擷取模型 | 1080、2026-10-02 | 來源一致性、算式與格式驗證 |
| 按企業規則決定核准、退件或人工審查 | Clef 類決策模型或明確規則引擎 | manual_review | 規則適法性、授權與例外管理 |
| 向客戶說明退貨方式 | 生成式語言模型 | 完整客服回信 | 內容、語氣、承諾及品牌審查 |
這份分工的價值,在於不用要求一個模型同時辨認資料、執行公司制度並負責對外溝通。單一步驟出錯時,能比較清楚地找到原因;有爭議時,也能保留每一階段的輸入、輸出與決策依據。
二、Clairic 究竟能處理哪些資料?九種型別背後的四類任務
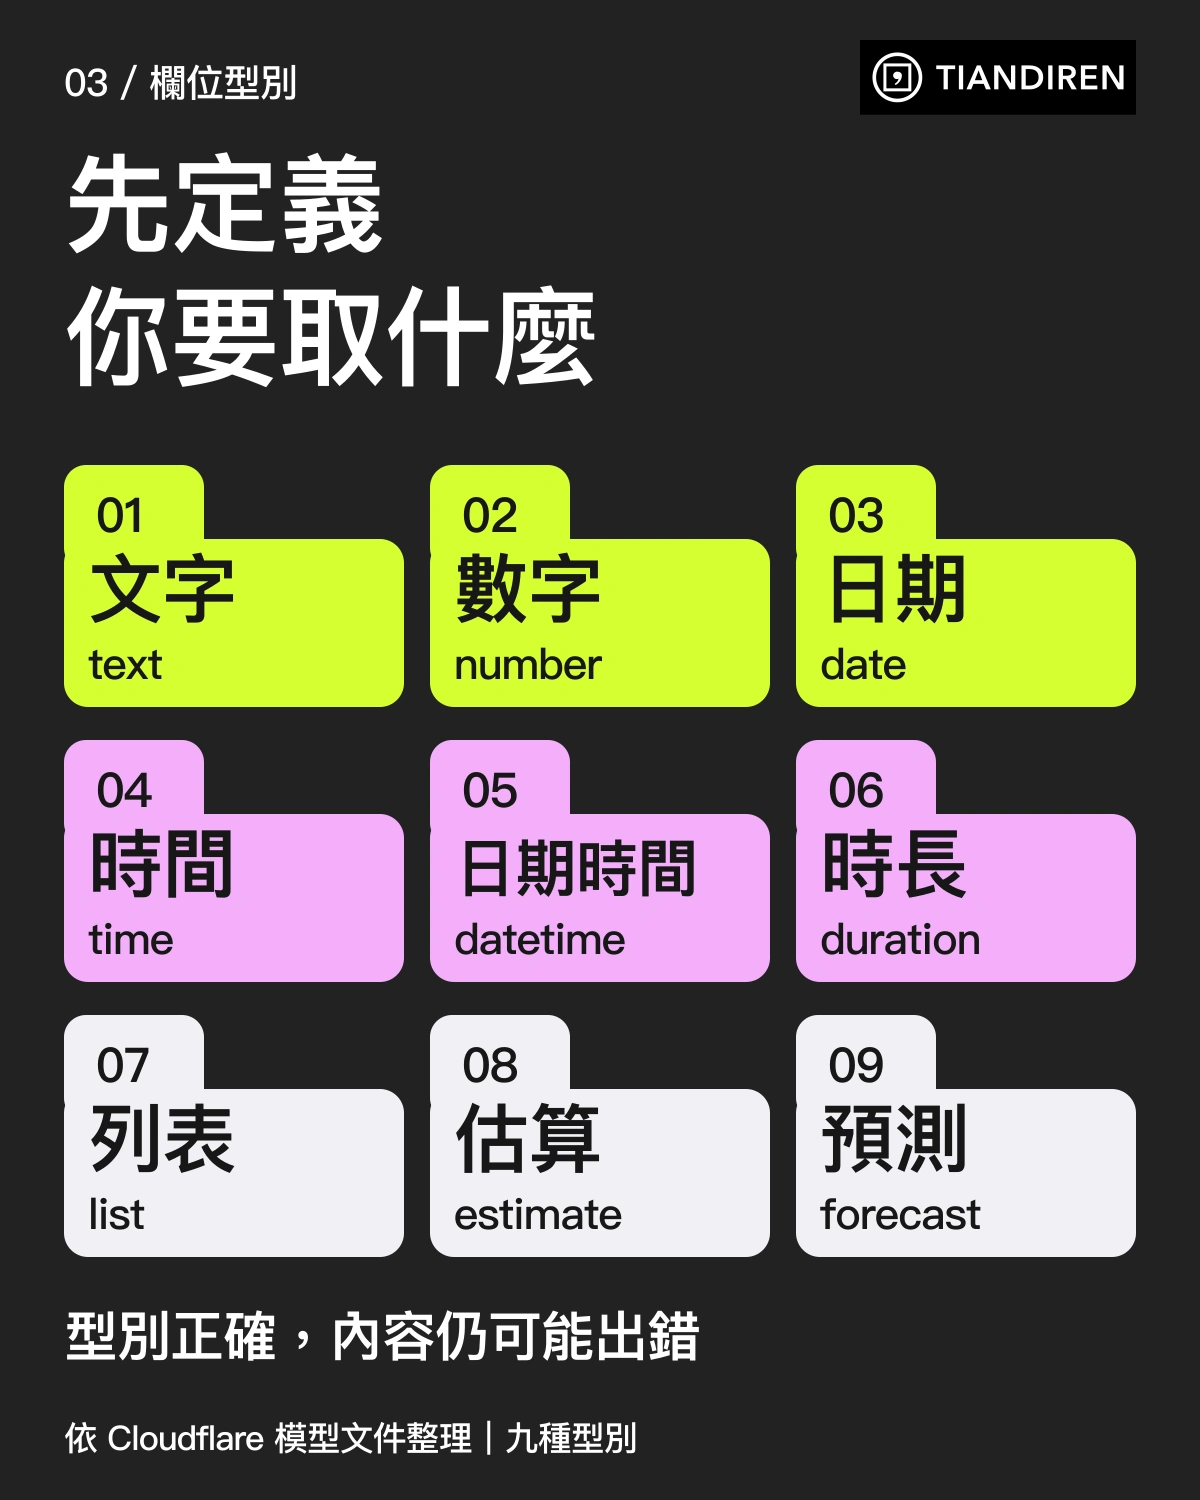
Cloudflare 文件把能力拆成四種:擷取(Extraction)、計算(Computation)、估算(Estimation)與預測(Forecasting)。這個區分很關鍵,因為它們對「正確」的定義完全不同。S4
擷取是找出資料中原本就存在的值。比如採購單的單號、廠商名稱或收貨日期。這類任務重視精確比對與追溯來源。計算是根據已知值推導新值,例如把數量乘上單價再加入運費。正確性可以由傳統程式重算。估算則是針對資料未明說的未知量提出分布,例如「這筆款項可能在幾天後入帳」,需要同時交代不確定性。預測是對未來連續多個時間點提出數值,例如未來數週的出貨量。預測不是已發生事實,而是對未來的假設。S4
| 欄位型別 | 主要用途 | 典型應用情境 |
|---|---|---|
text | 原文片段及位置 | 發票號碼、公司名稱 |
number | 數字擷取或簡單計算 | 應付金額、數量 |
date | 日期 | 付款期限、到貨日 |
time | 時間 | 預約時刻 |
datetime | 日期及時間 | 會議或派工時間 |
duration | 時長 | 延遲天數、處理工時 |
list | 多個符合條件的項目 | 聯絡人或貨品清單 |
estimate | 一個未知量的分布 | 預估維修費 |
forecast | 逐期未來數值 | 短期案件量、出貨量 |
這些資料型別不是為了讓輸出好看。真正的功能在於將可用範圍提前定義。日期必須是合法的日期,數字必須符合設定的數字規則,預測要落在指定範圍內。程式不必再從自由形式的段落猜測哪個片語代表金額。但符合型別,不等於符合事實:如果模型把 1,800 元看成 1,080 元,答案仍是合法數字,依然可能是錯誤資料。Cloudflare 的文件明確提醒不能把型別限制當成正確性保證。S4
每個欄位還帶著「不確定」
對單一值,Clairic 的結果可以包含 confidence 與 p_null。前者用於表達模型對回傳值的信心,後者反映輸入無法確定答案的機率;對估算與預測,則包含中位數及 p10、p90 等分位資訊,方便了解預測區間。S2S3
假設一筆報價單沒有採購單號,系統卻被要求擷取 po_number。這時候正確的業務行為通常不是從附近的發票編號猜一個號碼,而是回傳 null,將該筆送去補件。官方示例中,缺少採購單號時也能看見模型提供猜測值,但最終 value 為 null 的情形。開發者應以可用的最終結果及其驗證規則為準,而不是誤把輔助的 guess 欄位寫入正式系統。S3
在企業系統,是否可以不回答經常比「是否有答案」更重要。某些客服摘要可以容許小幅誤差,匯款帳號或放行金額卻不能。這意味著導入時應先為每一個欄位訂出風險等級,再決定哪些資料自動通過、哪些要交叉驗證、哪些必須由人員確認;不能只訂一個全系統通用的信心門檻。
三、System One 不是「比較笨的 LLM」,而是不同的計算設計
業界常把 AI 想成一條直線:模型越大、推理步驟越多、答案越好。但企業裡大量工作不需要寫作或深度推理。例如把案件編號從文字搬到資料庫、把付款日期轉換成標準格式,或估出一項費用的大致區間。對這些工作而言,逐字生成本身可能就是不必要的成本。
Cloudflare 借用「System One」描述能快速回答的模型類型,將它與需要多步推理的生成式模型區隔。Clairic 的關鍵特徵,是對預先定義的欄位產生直接結果,而不是自由生成長篇回覆。這是產品架構上的區別,不表示任何 LLM 都一定比較慢,也不代表沒有 token 生成就不會推論錯誤。應用效果仍取決於資料、題型、部署環境及驗證方式。S1
企業可以從計算責任理解這件事。若公司每天處理 50,000 筆客服與發票資料,其中 40,000 筆只需要擷取資料,5,000 筆需要依既有規則分類,另外 5,000 筆才需要完整文字回覆,那麼讓全部 50,000 筆都進入昂貴的生成流程,未必是最佳設計。這裡的筆數只是示意情境,並非 Cloudflare 或任何客戶的營運數據。
不要忽略「可預測輸出」與「可靠資料」之間的距離
模型提供固定型別,讓軟體接線更容易;但企業可靠性要靠整套系統。文字掃描可能錯、文件可能沒有關鍵欄位、發票可能重複、客戶可能蓄意填錯資料,而模型可能對錯誤值給出很高的信心。因此,真正可用的流程仍需要來源檔、欄位格式驗證、算式重算、交易對帳、異常分流與責任紀錄。Clairic 是其中一個資料轉換元件,不是全部的流程治理。
四、Cloudflare 公布的效能數字,應如何正確閱讀?
新品最容易吸引注意的,是比較表。Cloudflare 在 10 月 19 日的發布文章中,展示了兩組自行執行的測試。第一組是客訴理賠的端到端流程:先從信件擷取資訊,再依規則做決策,最後生成回覆。第二組則是使用美國運輸安全管理局(TSA)每日機場安檢人數資料做短期預測。S1
客訴流程:三段式模型與全部使用 LLM 的比較
| 指標 | Clairic → Clef → GLM-5.3 | GLM-5.3 全流程 | 資料性質 |
|---|---|---|---|
| 擷取階段耗時 | 0.46 秒 | 16.1 秒 | Cloudflare 自行測試 |
| 決策階段耗時 | 0.22 秒 | 21.9 秒 | Cloudflare 自行測試 |
| 生成回覆耗時 | 18.6 秒 | 16.4 秒 | Cloudflare 自行測試 |
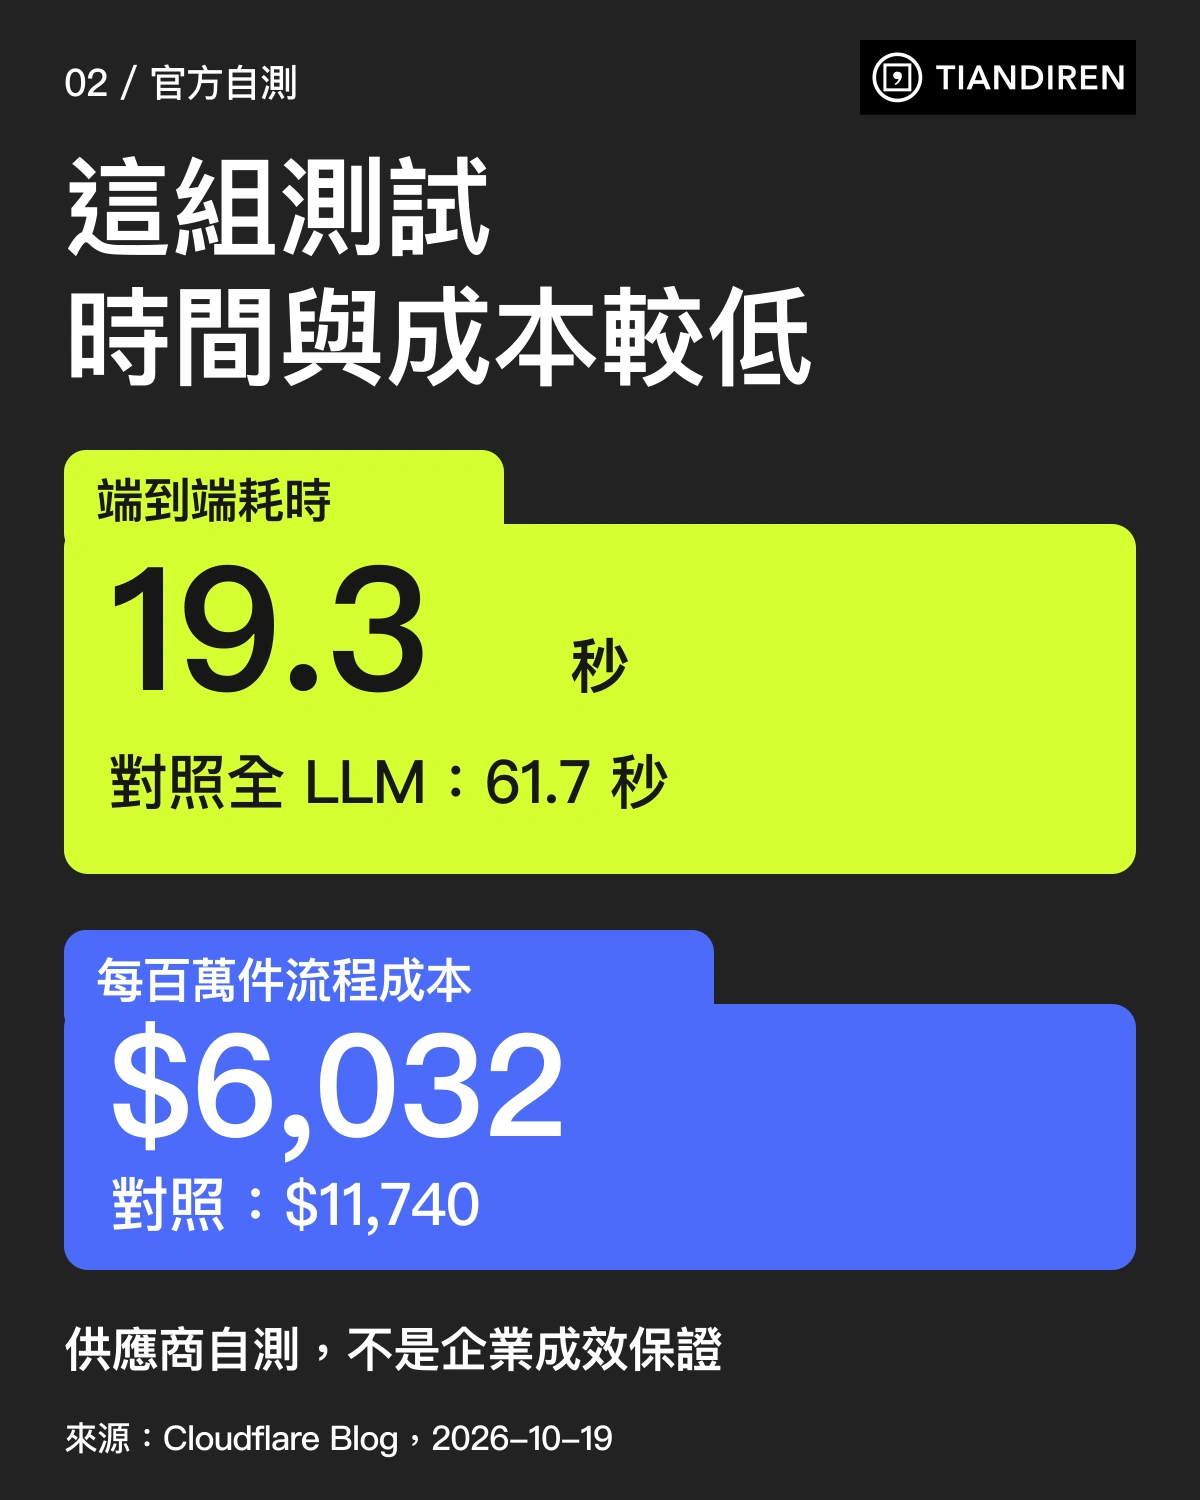
| 全流程耗時 | 19.3 秒 | 61.7 秒 | Cloudflare 自行測試 |
| 每 100 萬件理賠流程成本 | 6,032 美元 | 11,740 美元 | Cloudflare 依其測試條件估算 |
來源:Cloudflare 官方發表文章,2026 年 10 月 19 日。S1 這是特定測試題型、模型組合及部署條件下的供應商自測,不是第三方獨立驗證,也不是所有企業導入後的成本保證。
另須注意:官方原表所列 GLM-5.3 三段耗時相加為 54.4 秒,與其端到端欄位的 61.7 秒不一致。本文保留官方各欄位原值;原文未交代差值,本篇也未獨立重現。以下時間與成本比較均應依此限制閱讀。
從這組數據可算出,端到端時間約少了 69%,測試成本約少了 49%。更重要的觀察,是差距主要出現在前兩段。Clairic 與 Clef 的擷取及決策合計不到 1 秒;真正耗時的對外回覆仍然交給生成模型。也就是說,效益不是把 LLM 全數移除,而是把適合由專門模型執行的工作抽離,讓生成能力集中用在需要自然語言的地方。S1
這也揭露一個容易被誤讀的地方:表格並沒有證明 Clairic 能在任何文件、語言或企業資料庫上優於所有大型語言模型。它驗證的是發布者挑選的流程,在當次測試設定下比較快、成本比較低。要決定是否採用,還需要相同資料、相同正確率門檻、相同例外處理及完整人工作業成本的比較。只拿表上的秒數去推估全年節省成本,會忽略 OCR、API、錯誤重工與流程整合。
TSA 預測:21 天的結果既令人注意,也提醒我們謹慎
Cloudflare 另一個例子,是將歷史每日機場安檢人次提供給 Clairic,逐日預測次日人數,連續進行 21 天。官方表示平均誤差為 3.3%,實際數值有 17 天落在預測的中間 80% 區間內。該文同時指出,四次超出區間的情形中,有三次發生在 Columbus Day 連假附近;模型只能從給定的數列學習規律,無法事先知道未提供的特殊事件。S1
應如何理解?首先,這是由 Cloudflare 選擇的公開資料示範,並非通用預測競賽。其次,21 天的時間很短,不能直接外推到季節性、長期營運或不同產業。最後,「區間包含多少次真值」與「單點預測平均誤差」是不同指標。兩個都應衡量,但不能互相取代。如果企業要預測人力需求、庫存或現金流,仍須與簡單季節性基準、既有統計模型及專用時間序列模型做同場比較。
五、0.10 美元的定價為什麼值得注意?先把帳算對
Cloudflare 官方列示 Clairic 的單價是每 100 萬輸入 Token 0.10 美元,且不另外收取輸出 Token 費用。官方模型頁亦列出 65,536 Token 的 Context Window,支援文字與圖片輸入。S2S3
一個簡單的概念試算:假設每筆資料連同欄位定義平均需要 1,000 個計費輸入 Token,每月處理 100,000 筆,則總計為 100,000,000 個輸入 Token。按頁面列示的模型單價,推算的 Clairic 推論費用為 10 美元。這個數值只是公式示意,不是實際帳單,也不是總持有成本;實際使用的欄位 schema、影像、可能的多次處理及雲端服務費,都可能使計費與作業成本不同。
概念推論費用(美元)=計費輸入 Token ÷ 1,000,000 × 0.10。
Cloudflare 模型頁的範例回應中,state_tokens 為 61、schema_tokens 為 472,總計費輸入量 input_tokens 為 655,並顯示 passes 為 3。分項 61 與 472 的直接相加並不等於 655;官方範例未在此解釋差額,本文不自行補上原因。這提醒讀者,輸入 Token 不只包含要分析的正文,也涉及欄位規格等處理內容。估算時應以實際 API 使用量為準,不要用原始文件字數直接推算帳單。S3
更不能把 Cloudflare 公布的「每 100 萬輸入 Token 0.10 美元」理解成企業端到端流程每處理 100 萬筆只花 0.10 美元。前者是模型 Token 單價,後者涉及每筆資料有多少 Token、是否還需 Clef 與 LLM、影像處理、失敗重試及人工審核。Cloudflare 的客訴測試即顯示,完整流程另有生成模型的成本。S1
Workers AI 的 Token 標價與 Neurons 價格是同一模型運算費用的不同表示方式,不應把兩者當成兩筆模型費相加。官方平台仍以 Neurons 計帳,並有每日免費額度與方案限制;其他服務、影像前處理及人工覆核,則須依實際使用情況另外評估。正式上線前應重新確認價目表與帳戶條件。S6
六、企業可以拿 Clairic 做什麼?五個值得試行、也要知道限制的場景
1.財務與會計:先把傳票資料對齊,而不是直接代替審核
很多公司處理供應商請款,最耗時間的並不是核准按鈕,而是把發票、報價單、驗收單的日期、金額、稅額與文件號碼整理成一致欄位。Clairic 的擷取型別可用來建立第一層資料候選值,再以傳統程式執行三單比對、加總重算與例外分流。模型不能因此直接替代會計準則判斷,也不應單獨觸發付款指令。
可檢驗的成果不是「AI 會讀發票」,而是完整記錄每 100 張單據有多少張欄位全對、多少張需要人工覆核、每張平均省下多少純資料輸入時間,以及有沒有造成錯誤入帳。這些指標能直接回答財務主管是否值得投入。
2.客服與售後:減少同一封信被重複讀取
客服客訴有大量半結構化資訊:購買日期、商品型號、故障描述、聯絡方式、是否逾期與期望補償。透過 Clairic 擷取可核實資料,交給規則引擎或專責決策模型選擇下一步,最後才讓語言模型組織對外回覆。這與官方展示的三段式測試方向一致,但真實客服還涉及情緒、承諾與例外狀況,不能只依模型分數自動拒絕退款。S1
3.採購與供應鏈:讓不同格式資料進到同一條驗證流程
採購需求可能來自 Email、報價 PDF、Excel 表格或同仁的文字留言。先定義必要欄位,例如請購單位、商品、數量、價格、交期與指定供應商,再讓模型提供候選值。供應商名單、契約條款、採購門檻及簽核權限仍應與內部主檔或規則庫比對,不能僅因模型輸出型別正確便視為已符合採購政策。
4.業務與行政:減少重複複製貼上,但需審視個資
業務窗口常需要將來信與會議紀錄中的公司、日期、聯絡人、預算範圍、需求標籤放入 CRM。適合模型擷取的是明確記載於資料內的項目;對「這個客戶究竟會不會成交」等問題,若缺乏足夠歷史資料與校準,估算結果不能被包裝成確定商機分數。涉及客戶個資或公司機密時,還需處理資料最小化、存取授權、日誌保存與供應商契約。
5.短期營運預測:把它當基準參考,不當神諭
例如每週來電量、退貨件數、簡單運送量。Clairic 能輸出區間,適合初步比較近期模式,但官方坦言其預測仍屬基礎能力,無法預見輸入中不存在的節假日或促銷活動,不應直接取代專用時間序列模型。S2 真正可用的做法,是以真實已知歷史資料逐期回測,與移動平均、季節性基準及業務部門的預測相互比對,再決定是否採用。
七、它和 OCR、規則引擎、LLM Structured Outputs 有什麼不同?
若企業已經有 Excel 公式、正規表示式(Regex)、OCR 或現有 API,第一件事不是把所有流程換成 Clairic,而是辨識真正需要語義理解的部分。格式固定且資料來源穩定的表格,傳統程式通常更容易測試、重現與維護;如果輸入文件外觀高度變動、欄位名稱不一致、文字隱含語意,模型才可能顯示價值。
| 解法 | 較適合 | 主要限制 | 建議角色 |
|---|---|---|---|
| 表單、SQL、Regex、Excel 公式 | 格式固定、邏輯確定 | 異質文件與語意差異難處理 | 優先使用的確定性基礎 |
| OCR/文件辨識 | 掃描影像轉文字、版面定位 | OCR 正確不代表知道欄位意義 | Clairic 前段輸入或平行比對 |
| Clairic | 非結構化資料的型別化欄位 | 仍有錯誤、缺值、預覽版限制 | 候選值擷取與輕量估算 |
| LLM Structured Outputs | 複雜語義、解釋與生成並存 | 生成時間、成本及事實錯誤風險 | 需要彈性語意處理時使用 |
| 規則引擎/決策模型 | 按制度做分類或選擇 | 規則需維護,選項範圍有限 | 授權與流程分流 |
| 專用時間序列模型 | 長期、季節性或多變數預測 | 需合適資料、建模及維護 | 正式預測基準或主要模型 |
這不是對模型能力的普遍排名,而是依工作性質提出的選型原則。一個成熟的系統可以把多種工具放在不同位置:掃描 PDF 先做文件解析,模型辨認欄位,程式重算金額,規則引擎檢查權限,最後由同仁審核有爭議的案件。
八、從官方 API 範例看實作:先做一個不會付款的安全 Demo
Clairic 可透過 Cloudflare Workers 的 AI Binding 呼叫 env.AI.run(),或使用 Workers AI 的 REST API。下面採用官方欄位結構整理為教學用示意。範例不會連接銀行、ERP 或正式 CRM,也沒有真正發出 API 呼叫;讀者必須先建立 Cloudflare 帳戶、完成 Workers AI 設定與權限驗證。S3
export interface Env { AI: Ai }

export default {
  async fetch(_request: Request, env: Env): Promise<Response> {
    const result = await env.AI.run("@cf/cloudflare/clairic", {
      model: "clairic",
      state: "發票 INV-2291,2026-09-02 開立,付款條件 30 天。4 個棧板,每個 250 美元,運費 80 美元。",
      fields: {
        invoice_number: { type: "text", instructions: "擷取發票編號" },
        due_date: { type: "date", instructions: "依開立日與付款條件推得付款日" },
        total: { type: "number", decimals: 2, unit: "USD", instructions: "總金額含運費" }
      }
    });
    return Response.json(result);
  }
};
程式為教學用的 TypeScript 示意,依官方文件調整中文輸入;目前未進行編譯、Cloudflare 帳戶實際呼叫或中文準確度測試。正式部署前需核對 SDK、型別、部署設定及完整 API 回應。
實際執行後,應先把模型回應送到驗證程式,而不是直接寫入正式表格。驗證包含:日期確為合理的付款日、數值為可接受的正數、發票編號與來源文字一致、合計可重算、是否有缺值,以及交易是否與既有資料重複。若條件不符就先進入審核佇列。這一步最能區分「做得出 Demo」與「可交由員工每天使用」。
六個步驟完成可驗收的 PoC
- 選一種文件與一種工作成果。 例如只處理一種請款單,產出固定五個欄位的 CSV,不要把所有文件、法規與系統一起納入。
- 建立已人工核定的測試資料。 建議先收集 100~300 筆經適當去識別化的不同版型文件,納入缺欄、重複、金額混淆及錯誤日期。這是專案建議樣本量,不是官方規定。
- 先測既有方法。 用人工、Excel、OCR 或現用 LLM 建立相同輸入與驗收方法的基準,記錄欄位正確率、單件時間與重工作業。
- 建立 Clairic 欄位規格。 將
state、fields、必要型別、資料單位與缺值處理規則寫成版本化設定,避免每次測試暗中調整問題。 - 跑盲測與人工覆核。 每筆輸出與人工標準答案逐欄比對,區分擷取錯誤、計算錯誤、缺值誤判、OCR 失真、預測誤差。
- 核算完整成本與風險。 納入 Token、前處理、人工覆核、錯誤重工、系統維護、權限治理與資安審查,再決定是否導入下一階段。
這六個步驟背後的第一性原理是:先證明能減少一件實際工作的總成本,再選擇技術。 沒有標準答案的測試,無法比較準確率;沒有現行流程基準的測試,無法證明省時;沒有處理例外成本的測試,也無法證明省錢。
九、企業級架構:不要讓模型直接成為付款權限
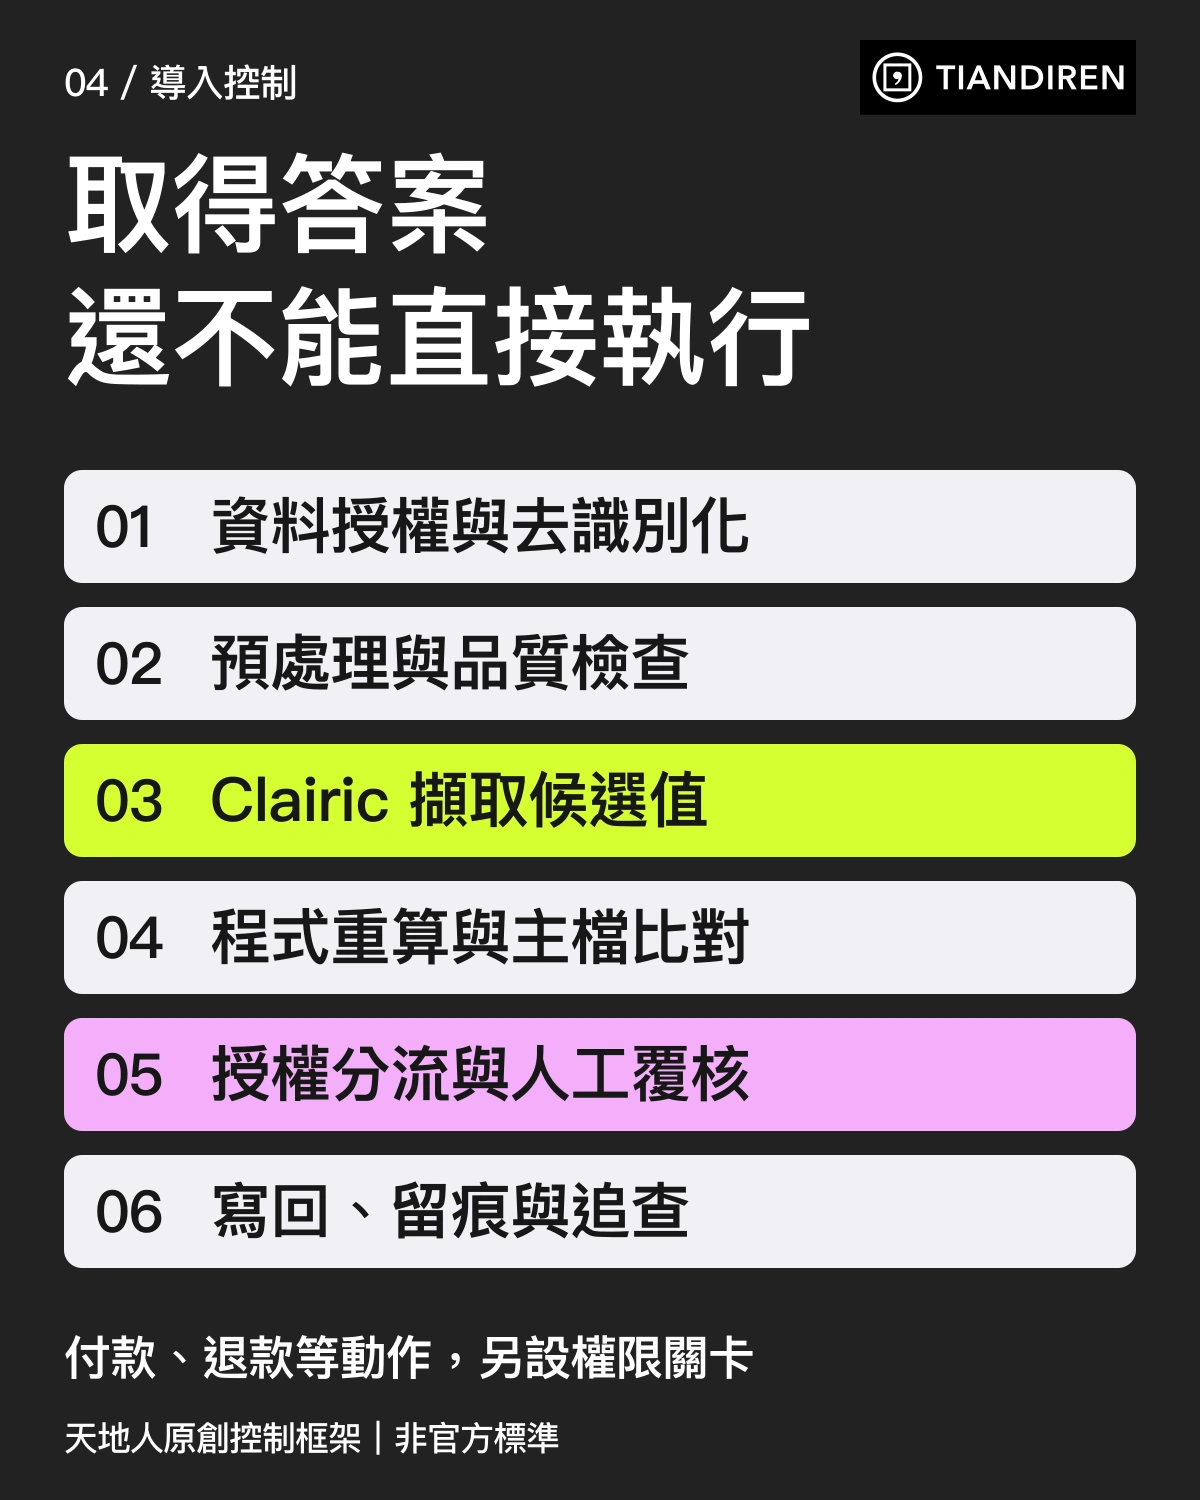
一個比較可靠的資料處理架構,可以拆成六層。第一層是來源與授權,確認誰能上傳資料及資料保存條件。第二層是文件預處理,負責格式轉換、OCR、錯誤頁面與重複附件處理。第三層是 Clairic 擷取候選資料,保留型別、信心及缺值標記。第四層是確定性驗證,執行金額重算、主檔交叉比對、值域檢查與例外清單。第五層才是依制度分流,決定通過、退回或人工覆核。第六層是寫回及稽核,只允許授權流程接觸正式 ERP/CRM/財務系統。
若有生成式 AI Agent,最安全的角色是負責人機溝通、提出建議及輔助操作,而不是在沒有授權檢查的情況下直接呼叫付款工具。某個模型即使每次輸出相同結果,也無法替企業承擔核准責任。企業還應定義事件紀錄、失敗重試、可追溯的模型與欄位規格版本,以及異常時的人工接手機制。
本文流程圖與治理圖為天地人編輯提出的應用設計,並非 Cloudflare 產品內部架構的逆向工程或官方設計圖。
預覽版要特別注意的五件事
第一,計算能力有範圍。 官方說明一到兩步的基本運算較可靠,但多步依賴計算與大表格聚合並非目前強項。實際系統應優先讓 Clairic 擷取數字,再交由程式完成複雜算術。S2
第二,預測不應被過度延伸。 預測常見模式,不等於能預知節假日、政策調整或突發事件。重要預測應與專用模型比較,並定期回測。S2
第三,信心不是保證。 型別合法、confidence 很高、區間看似狹窄,仍可能在陌生資料上失準。門檻只能由真實資料校準,不應直接照抄別人的範例。S2S4
第四,文件有硬性限制。 官方模型頁列出 65,536 Token Context Window、最多四張圖片的輸入條件,並指出欄位過多時會拆成平行處理。開發時還須關注每張圖片大小、請求體積、欄位數量與實際計費;不能只看上限就假定任何長文件都能一次、低成本而完整處理。S3
第五,正式環境要看服務條款與資料流。 模型目前是 Preview,Cloudflare 文件載有可用性及免責條件;企業如處理個資、合約、財務或受規管資料,應由 IT、資安、法務與資料擁有者一起確認外部傳輸、日誌設定、保留時間及應用邊界。S3 如果經由 AI Gateway,Cloudflare 文件提到日誌可能包含提示詞、回應與其他中繼資料,並提供避免儲存 payload 的設定選項。這不代表所有使用方式都自動符合企業的隱私要求。S7
延伸實作:把準確率量成可以決策的證據,而不是一個漂亮百分比
模型測試常出現一個問題:團隊說「準確率達到 95%」,但沒有交代準確率的分母到底是什麼。假設一張發票需要填入十個欄位,其中九個正確、一個金額錯誤,這張發票算成功還是失敗?如果系統只統計單一欄位正確率,它可能得到 90%;若業務流程要求十個欄位全部無誤,該筆其實不能自動放行。兩種統計方法回答的問題不同,都可能需要,但不能混用。
實務上應把指標分成至少四層。第一層是欄位準確率,每個欄位分別衡量精確比對、數字容差和日期正確性。第二層是整筆資料完整正確率,要求一張單據所有必需欄位同時正確。第三層是自動通過率,衡量在可接受風險門檻下,哪些案例可以完全不經人工補正。第四層是錯誤外溢率,專門統計原本應被擋下的錯誤,卻順利寫入正式流程的比例。對於付款金額、銀行資訊、合約期限之類欄位,第四個指標的業務意義可能遠大於平均準確率。
應用時,人工答案也不一定毫無錯誤。兩位審核員對同一份資料可能有不同判斷,因此應制定標準答案製作規則、矛盾案件的仲裁程序,以及更改答案後的版本記錄。沒有這套基礎,模型評分只是在測它和某位人工標註者有多像,未必符合企業真正的制度。
建立「錯誤分類表」,才知道改善哪一段
| 錯誤種類 | 看見的現象 | 優先排查的地方 |
|---|---|---|
| 原始文件不清楚 | 掃描模糊,文字殘缺 | 掃描、OCR、檔案品質 |
| 欄位定義不清 | 稅前與稅後金額混淆 | fields 的定義與說明 |
| 內容中沒有答案 | 強行把其他編號當成訂單號 | p_null、缺值與人工補件規則 |
| 多文件內容衝突 | 合約與 Email 的交期不同 | 文件優先順序、版本與來源 |
| 計算跨越多個步驟 | 大量明細加總出錯 | 改以程式重算 |
| 預測缺少情境 | 連假或促銷使預測偏離 | 加入外部特徵或換用專用模型 |
| 格式符合卻內容錯誤 | 合法日期並非真實到期日 | 主檔交叉比對、人工覆核 |
| 例外沒被擋住 | 高風險案件自行通過 | 風險門檻、核准規則及權限 |
錯誤分類能讓團隊避免每次看到錯誤就急著「修改 Prompt」。若問題其實出在掃描品質,增加提示詞未必有效;若是複雜加總應交給程式,反覆要求模型更仔細計算也不是最佳路線。改善方向應直接對應失敗原因。
信心門檻該設多少?先做校準,再談自動化
許多系統偏好設定單一門檻,例如信心分數超過 0.9 就自動通過。但若模型對某類資料過度自信,0.9 不代表仍有九成正確率;尤其不同欄位、不同來源或不同月份可能有完全不同的錯誤模式。Cloudflare 官方同樣提醒,信心及預測區間在陌生資料上可能校準不足。S2S4
比較妥當的方法,是把測試資料依文件來源、欄位類型、風險等級切分,再畫出不同信心區間的實際準確率。只有當企業找到可接受的區間並持續監控,才讓低風險資料走自動流程。高風險欄位即使信心很高,也可要求規則比對或人工覆核。不要把「模型很肯定」視為對使用者的責任保證。
延伸實作:一個 4 週試點應交出哪些具體成果?
如果企業想把這項產品從新聞議題變成營運選項,建議以四週為一期進行小範圍驗證。這是本文的實務規劃,不是 Cloudflare 的官方推廣流程。四週的目的不是追求大型系統上線,而是以有限人力辨識是否值得繼續投資。
第一週:界定工作與整理資料。 流程負責人應提供任務起點、終點、平均處理時間及例外樣態。IT 盤點資料來源、存取權限及是否需要去識別化。最後產出一份欄位字典,列出名稱、型別、定義、來源、必填與否、驗證規則,以及發生錯誤的業務後果。這份字典比技術示範影片更值得保存,因為未來不論用哪一個模型,都能重複使用。
第二週:建立比較基準與最小示範。 先用現有方法處理同一批樣本,再讓 Clairic 在相同輸入上取得結果。測試時要記錄完整耗時,包括文件整理、傳輸、API 呼叫、格式驗證、人工補正及寫回。若只有模型運算時間,可能低估整體流程的負擔。實務驗證要保留原始輸入與回應,但敏感資料的存取及日誌保存必須先經授權確認。
第三週:壓力與例外測試。 刻意加入沒有日期的文件、重複的發票號碼、兩種幣別、錯位金額、附件缺頁與長篇多欄位資料。不要把這些全當成模型該解決的問題,而要觀察整體系統能否在可控條件下拒絕、標示或轉派。做得好的 PoC 不一定「什麼都能回答」,而是能在不知道時停止危險動作。
第四週:決策與交接。 將資料、模型設定版本、準確率報告、錯誤分類、工時比較與風險清單交給流程負責人。最後只回答三個問題:在固定品質門檻下是否真的省下人力?新增維運風險是否可控?若下個月資料格式改變,誰負責偵測及修正?答案足夠明確,再進入更大規模的系統串接。
以營運指標判斷是否值得投資
假設某團隊每月處理 10,000 筆文件,原本人工作業平均每筆 3 分鐘。若新流程可以在風險門檻下自動處理其中 60%,其他仍需人工,而且自動成功部分平均只需 20 秒的例行檢查,這樣才有條件估算可能節省多少人時。但實際運作可能還會產生監控、資料修正、主管覆核與系統維護時間,因此上述數字必須作為示意假設,不能當作既有客戶成效。
比較方案時,建議把「每件平均成本」拆成五塊:人工作業、模型費用、文件前處理、異常重工、平台及維護。若某方案只在模型成本便宜,卻在總時間或錯誤外溢率方面沒有改善,企業不一定應採用。這個做法能避免成本討論只停留在每百萬 Token 多少美元。
延伸分析:Clairic、AI Agent 與企業權限的真正關係
當 AI Agent 可以替員工使用工具時,企業最怕的是「讀到一封信,就做了一個不該做的動作」。外部來信可能包含錯誤資訊、偽裝指令,甚至刻意要求系統違反既有流程。把擷取、決策與生成拆開,能讓每個元件接觸的內容更有界線;例如文字模型只需要看到已核准的案件摘要,而不必取得原始客戶郵件及所有內部授權指令。Cloudflare 官方發布文章也以這種方式解釋其串接流程的可稽核性。S1
但分層並不是自動完成資安。若抽取出來的資料本身帶著惡意內容,或下游程式錯把自由文字當成可執行指令,仍可能造成問題。工程上應將文件內容視為不可信輸入,讓欄位值只進入有明確格式、權限與值域的流程;牽涉外部系統操作時,還必須使用工具層級的權限與明確批准。模型的角色是提供資料,不是凌駕既有資安政策。
台灣企業還有一個常見情境:同一套系統同時處理繁體中文、英文、數字、幣別及外國日期格式。一份報價單可能寫「1,200 元未稅」,另一份寫「USD 1,200」,第三份把年份省略。資料整理時最危險的不是系統不能辨認,而是辨認後悄悄將不同含義變成同一種格式。因此欄位字典應將幣別、稅別、時區、日期採用的參考日及單位設定視為必要資料,而不只是輸出一個數字就完成工作。這些需求必須透過台灣本地資料集自行驗證,不能因為英文官方 Demo 成功就假定中文環境同樣準確。
只有當企業把資料語意、模型輸出、決策授權與異常管理分成不同責任,AI Agent 的自動化才比較可能從展示用途變成可信的長期流程。
十、Clairic 的真正影響:企業 AI 將從「模型中心」走向「任務中心」
生成式 AI 浪潮推動了企業從文件搜尋、行銷文案到知識庫問答的各種嘗試。當第一波試驗進入常態營運後,問題逐漸從「能不能做」轉為「能不能穩定、便宜、快速地做」。這時候,比起讓一個模型包辦所有事,更重要的是拆解任務,判斷哪些需要語意生成,哪些只需要取值,哪些可以用簡單程式完成,哪些必須交給人員核准。
Clairic 提供了一個值得觀察的方向:把取值視為獨立 AI 能力,使它和規則、決策模型、語言模型分工。若未來這種工具在跨語言、多文件與高風險流程上的表現獲得更廣泛驗證,企業流程設計可能逐步改變;但截至 2026 年 10 月 21 日,Clairic 仍是預覽版,公開數據以官方示範為主,尚不足以推論所有產業的廣泛效益。S1S2
對經營者來說,應該問的不是「我們要不要用 Clairic」,而是「企業每天有哪些固定欄位,仍讓員工花時間從 Email、PDF、Excel 和系統畫面反覆複製?」先找到這些重複性的高頻工作,定義標準答案及錯誤成本,再比較人工、程式與不同 AI 工具。如此選型才能回到商業問題本身。
十一、管理者可以直接採用的決策清單
在採購或試點前,請業務單位、IT 與流程負責人共同回答下列問題。
| 決策問題 | 必須取得的證據 | 未取得時怎麼做 |
|---|---|---|
| 任務是否只需要固定欄位? | 欄位規格、典型文件 | 先定義輸出,不急著選模型 |
| 來源資料能否合法使用? | 授權、保留及資料分類 | 先做去識別化與法務審視 |
| 正確答案如何認定? | 人工標準答案與例外規則 | 暫停準確率宣稱 |
| 錯誤會造成多大損失? | 金額、客訴或法遵風險評估 | 保留人工關卡 |
| 與現有方法相比是否進步? | 同題盲測、總工時與總成本 | 不憑官方宣傳判斷 |
| 長期可否維護? | 版本、監控、回滾及授權紀錄 | 先做範圍較小的試點 |
採購決策還可以加上三個量化指標:欄位級正確率(每欄與標準答案一致的比例)、可自動通過率(在既定風險門檻下可不經人工處理的比例)、完整單件成本(包括人力、重工與系統費用)。三者不可只取其一。高正確率但低自動通過率,不一定能改善流程;低 API 成本但頻繁重工,也不一定比較便宜。
常見問題 FAQ
Clairic 是聊天機器人嗎?
不是。它是 Cloudflare Workers AI 上的型別化資料擷取模型,設計目的是從輸入資料產生特定欄位的值,而非開放式對話。S3
Clairic 可以直接讀圖片嗎?
官方模型頁標示支援 Vision,且一次請求可帶入最多四張圖片,但有檔案大小與請求體積限制,仍需依最新文件核對。S3
Clairic 會比 GPT 或其他 LLM 準確嗎?
不能一概而論。Cloudflare 官方在特定客訴流程展示較低延遲與成本,但那是供應商測試,不等於所有語言、文件與題型的全面勝出。S1
Clairic 可以拿來預測營收嗎?
它支援估算與預測型別,但官方明言現階段預測基礎,不能取代針對業務資料訓練的專用時間序列模型。重要營收預測應有歷史回測與人員審查。S2
為什麼模型沒有產生輸出 Token,卻仍會有計費?
因為官方對 Clairic 的計費依據是輸入 Token。文件本文與欄位 schema 都可能進入計費使用量;完整流程中的其他模型與服務仍可能收費。S2S3
它可以直接替企業核准付款嗎?
技術上能把應付金額等資料轉成程式可用的型別,但付款核准還需授權、法遵、內部控制與例外處理。本文不建議將抽取結果直接連接不可逆的付款操作。S4
目前是開源模型嗎?
截至本篇查核時,Clairic 以預覽版託管服務提供。Cloudflare 表示有意推出開放權重,但尚不應將未來計畫寫成已正式發布開放權重。S1S2
台灣企業該從哪裡開始?
先選一種具有明確標準答案、風險可控而且量足夠大的重複性文件工作,建立去識別化資料集及現有流程基準,再進行欄位級盲測。驗收通過後,才考慮與內部 ERP、CRM 或自動化流程串接。
下一步:真正值得導入的,不一定是最新的模型
如果企業正在評估 AI 應用,第一步可將最花時間的行政、採購、客服或財務資料處理工作列出,確認每項工作的輸入、決策與輸出。將「能用 Excel 或程式算的」、「適合 AI 擷取的」、「需要生成文字的」以及「必須有人核准的」工作分開,往往比一開始就選定 AI 平台更能降低導入風險。
天地人文創的企業培訓與 AI 導入評估可從實際工作流程出發,協助團隊建立資料處理 PoC、驗收指標、AI 工具選型及人員作業規範。本文定位為資訊研究與實務判斷,非 Cloudflare 官方合作、代理或認證宣告。關於課程與培訓服務,請從 天地人文創官網 查詢目前可用資訊。
來源與查核說明
本篇以 Cloudflare 官方發布與開發文件為主要來源。對外公布的延遲、成本及預測成績屬供應商自測,不代表天地人已獨立複現。本文所有表格中的「建議」「假設」「設計」與範例均為編輯分析,不應誤認為 Cloudflare 官方承諾。
- [S1] Cloudflare Blog,Introducing Clairic, a new System One class of extraction models,2026-10-19。https://blog.cloudflare.com/clairic-extraction-model/
- [S2] Cloudflare Developer Changelog,Introducing Clairic: an extraction model for typed values, now on Workers AI,2026-10-19。https://developers.cloudflare.com/changelog/post/2026-10-19-clairic-workers-ai/
- [S3] Cloudflare Workers AI Model Docs,clairic,查閱 2026-10-21。https://developers.cloudflare.com/workers-ai/models/clairic/
- [S4] Cloudflare Workers AI Concepts,Extraction models,查閱 2026-10-21。https://developers.cloudflare.com/workers-ai/concepts/extraction-models/
- [S5] Cloudflare Blog,Introducing Clef: our open-source decision models,查閱 2026-10-21。https://blog.cloudflare.com/clef-decision-models/
- [S6] Cloudflare Workers AI Docs,Pricing,更新 2026-10-20;查閱 2026-10-21。https://developers.cloudflare.com/workers-ai/platform/pricing/
- [S7] Cloudflare AI Gateway Docs,Logging,查閱 2026-10-21。https://developers.cloudflare.com/ai-gateway/observability/logging/
編輯註:本篇目前未進行 Cloudflare API 實測及實際企業現場案例訪談,相關建議應視為可實作的方案設計,而非已驗證商業成效。任何法律、資料保護及業務授權的判斷須由企業依當地法令和合約確認。
圖片與素材說明
封面:原創資訊圖。以資料夾分層表達工作分工,非 Cloudflare 官方圖。
本文由 TARAISG(TIANDIREN AI SOLUTION GROUP)使用 AI 模型產生正文、整理來源並設計實務工具。方法依據與限制列於文末;案例為明確標示的教學假設。未有具名紀錄時,不宣稱經人工或專家審核。
查看內容製作與更正說明



