AI 工作實務
Tesseract OCR 繁體中文教學:發票、合約掃描檔的辨識與限制
Tesseract 5 如何辨識繁體中文?說明 chi_tra 模型安裝、PSM 選擇、TSV 與可搜尋 PDF 輸出、PDF 先轉影像,以及發票、合約、手寫與 RAG 情境中必須保留的人工覆核。

本文目錄
先確認:Tesseract 能做什麼、不能做什麼4 個技術重點:影響辨識品質的關鍵安裝與版本確認第一個可執行範例:中英文辨識與 TSV 輸出8 個實務情境:發票、合約與 RAG常見錯誤、原因與修正上線前驗收清單常見問題官方資料來源延伸閱讀與企業實作Tesseract 5 如何辨識繁體中文?說明 chi_tra 模型安裝、PSM 選擇、TSV 與可搜尋 PDF 輸出、PDF 先轉影像,以及發票、合約、手寫與 RAG 情境中必須保留的人工覆核。
財務每月收到上百張紙本發票,法務要從掃描合約裡找條款,客服要把手寫收件單輸入系統。Tesseract 是最常被拿來做第一步的開源 OCR 引擎,能把影像變成可搜尋、可處理的文字。
不過 OCR 只負責「認字」,認出來的字對不對、該填進哪個欄位,需要另一套規則和人工覆核。本文以 Tesseract 5.5 搭配繁體中文模型實測,說明安裝、參數選擇、輸出格式與發票、合約等場景的實作限制。
重點回答:Tesseract 是開源 OCR 引擎,能把掃描影像轉成文字或可搜尋 PDF,高風險欄位仍需人工覆核。
先確認:Tesseract 能做什麼、不能做什麼
| 項目 | Tesseract 本身 | 需要另外處理 |
|---|---|---|
| 印刷體繁中、英文 | 可辨識(需 chi_tra 模型) | 依版面測量準確率 |
| 文字座標與信心值 | TSV、hOCR 輸出 | 欄位對應規則 |
| 可搜尋 PDF | 可輸出 | 多頁 PDF 拆頁與合併 |
| 直接讀 PDF 檔 | 不支援 | 先用 pdftoppm 轉成影像 |
| 手寫字 | 效果有限 | 人工登打或其他模型 |
| 發票真偽、金額正確 | 無法判斷 | 稅務查驗與內控流程 |
需要大量處理 PDF 的團隊,可以評估以 Tesseract 為核心的 OCRmyPDF,它會處理拆頁、辨識與合成可搜尋 PDF 的流程。
4 個技術重點:影響辨識品質的關鍵
繁中模型要先裝好、再確認
Linux 上通常要另外安裝 tesseract-ocr-chi-tra 套件。執行 tesseract --list-langs 應看到 chi_tra,直排文件則要 chi_tra_vert。
官方提供三種模型:tessdata、tessdata_best(較準、較慢)與 tessdata_fast(較快、較不準)。正式導入前用同一批樣本比較,不要假設某一種一定最好。
PSM 決定讀取順序
--psm 告訴 Tesseract 版面是什麼樣子。預設的 3 會自動分析版面;6 把整張圖當成一個文字區塊;4 適合單欄但字級不一的文件;11 用來找零散文字。
兩欄式表單用錯 PSM,左右兩欄的文字會被讀成同一行。這種錯誤在純文字輸出裡很難發現。
影像品質比參數更重要
官方建議影像解析度至少 300 DPI。歪斜、陰影、低對比和 JPEG 壓縮雜訊都會明顯降低準確率。
前處理(轉正、裁邊、去雜訊)要保留原圖,並用標註過的正確答案比較前後差異。過度二值化可能把中文的細筆畫一起抹掉。
OCR 和欄位擷取要分層
Tesseract 輸出的是文字與位置,不知道哪一串數字是發票號碼。欄位擷取要另外寫規則,並對格式做檢查,例如統一編號是 8 碼且有檢查碼規則,可以先用程式驗證格式。
安裝與版本確認
Debian/Ubuntu 可用 sudo apt install tesseract-ocr tesseract-ocr-chi-tra 安裝主程式與繁中模型。Windows 常用 UB Mannheim 提供的安裝程式,安裝時要勾選繁體中文語言檔。
裝好後執行 tesseract --version 與 tesseract --list-langs。找不到語言檔時,可用 TESSDATA_PREFIX 環境變數或 --tessdata-dir 參數指定 tessdata 資料夾。
第一個可執行範例:中英文辨識與 TSV 輸出
以下在 Tesseract 5.5.0、Debian 的 chi_tra 套件實測。invoice_zh.png 換成自己的掃描檔即可。
tesseract --version
tesseract --list-langs
tesseract invoice_zh.png output/invoice_zh -l chi_tra+eng --psm 6 txt
tesseract invoice_zh.png output/invoice_zh -l chi_tra+eng --psm 6 tsv
tesseract invoice_zh.png output/invoice_zh_pdf -l chi_tra --psm 6 pdf
txt 輸出純文字;tsv 每一列是一個字詞,含頁碼、區塊、座標與 conf 信心值;pdf 產生在原影像上疊加文字層的可搜尋 PDF。
PDF 掃描檔要先轉成影像再辨識:
pdftoppm -r 300 -png scan.pdf page
for p in page-*.png; do tesseract "$p" "${p%.png}" -l chi_tra --psm 3 txt; done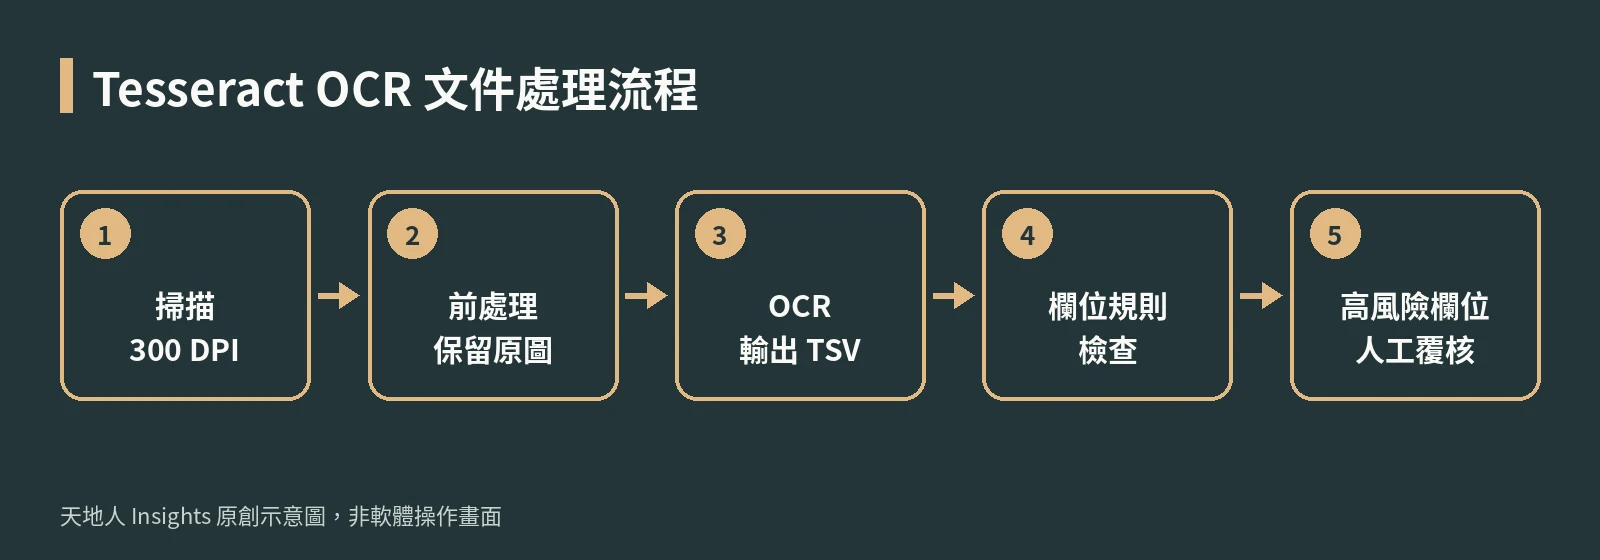
8 個實務情境:發票、合約與 RAG
以下情境是為說明 OCR 限制而設計的教學範例,並非實際客戶專案或準確率報告。
情境 1:應付帳款發票
發票上有統編、日期、稅額與品名。OCR 只產出文字,金額要再比對小計、稅額與總額是否相符,統編與發票號碼用格式規則檢查。
數字 8 和字母 B、數字 0 和字母 O 最容易混淆。任何會影響付款的欄位,都要保留人工覆核。
情境 2:繁中合約掃描檔
合約每一頁分開保存影像與頁碼,OCR 文字讓全文可搜尋。印章常蓋在條文上,被遮住的字可能辨識錯誤或缺漏。
引用條款時一定要回到該頁影像核對。OCR 結果可以縮短找資料的時間,但不能拿來做法律判斷。
情境 3:兩欄式表單
兩欄表單或含表格的文件,先比較 --psm 3 與 --psm 6 的讀取順序。TSV 與 hOCR 會保留每個字詞的座標,可以依位置把文字分回正確欄位。
順序錯亂的純文字不要直接拿去做摘要,否則左欄的問題可能配上右欄的答案。
情境 4:手寫收件紀錄
Tesseract 的模型以印刷體為主,對草寫與非標準字形效果有限。先抽樣測量字元錯誤率(CER)或欄位正確率,再決定是否適用。
達不到標準的文件類型,直接分流到人工登打。不要把低信心的辨識結果塞進正式資料庫。
情境 5:中英混合文件
英文條款夾帶中文說明時,可以分別試 -l eng、-l chi_tra 和 -l chi_tra+eng。語言組合不一定比單一語言準,要用實際樣本比較。
驗收時分語言抽查關鍵詞,例如英文的金額單位與中文的品名。
情境 6:歪斜與低對比掃描
掃描時紙張歪斜或對比不足,可以先轉正、調整對比、降低雜訊。每種處理都另存一個版本,保留未處理的原圖。
用同一組標註好的正確文字比較各版本的 CER,才知道前處理是真的改善,還是只是看起來比較清楚。
情境 7:個資與暫存檔
OCR 的 TXT、TSV 和可搜尋 PDF,內容和原始掃描一樣敏感。這些中間檔不能因為「只是暫存」就放在共用資料夾或公開的雲端儲存空間。
辨識作業在授權的內網環境執行,並設定保存期限與最小權限,到期自動刪除。
情境 8:OCR 文字餵給 AI 問答(RAG)
把掃描文件的 OCR 結果放進 AI 知識庫前,每一段文字都要綁定來源文件編號、頁碼與在頁面上的位置。
語言模型可能對錯字做出流暢但錯誤的推論。回答要附上來源頁,讓使用者可以點回原始影像確認。
常見錯誤、原因與修正
| 現象 | 常見原因 | 修正方式 |
|---|---|---|
| 出現「Error opening data file」 | 沒有安裝 chi_tra 模型 | 安裝語言套件並用 –list-langs 確認 |
| 中文變成亂碼或英文字母 | 只用了 eng 模型 | 加上 -l chi_tra 或 chi_tra+eng |
| 兩欄文字混在一行 | PSM 不符合版面 | 改用 –psm 3 或 4,或依 TSV 座標分欄 |
| 輸入 PDF 失敗 | Tesseract 不讀 PDF | 先用 pdftoppm 轉成 300 DPI 影像 |
| 細字消失 | 前處理過度二值化 | 保留原圖並比較 CER |
上線前驗收清單
- 每類文件都有一組標註好正確答案的樣本,並量過準確率。
- 掃描解析度、語言模型與 PSM 設定已固定並記錄。
- 金額、統編、日期等欄位有格式與交叉檢查規則。
- 低信心或檢查不通過的結果會進入人工覆核佇列。
- OCR 中間檔有存取權限與保存期限。
常見問題
Tesseract 可以直接讀 PDF 嗎?
不行。Tesseract 的輸入是影像,PDF 要先轉成 PNG 或 TIFF;若要整份 PDF 自動處理,可以評估 OCRmyPDF。
安裝繁體中文模型後就一定準嗎?
不一定。準確率取決於影像品質、字型、版面與 PSM 設定,要用自己的文件樣本實際量測。
Tesseract 可以辨識直排中文嗎?
可以使用 chi_tra_vert 模型處理直排文字,但古籍、混排或表格版面仍需依樣本測試。
OCR 可以判斷發票真偽嗎?
不能。文字辨識不等於稅務查驗,發票真偽與金額仍應依主管機關的查詢管道與企業內控流程確認。
官方資料來源
圖片為原創示意圖。
延伸閱讀與企業實作
- ImageMagick 批次處理產品圖:縮放補白、轉 WebP 與上傳安全
- 單據辨識率很高,為什麼財務還是很忙?真正要自動化的是例外處理
- 讓 AI 同時讀照片、文件與語音,企業可以重新設計哪些工作流程?
- AI 幻覺怎麼管?用客服知識庫追到錯誤發生的位置
財務、法務或客服若正考慮用 OCR 處理發票與掃描文件,建議先準備 30 到 50 份已脫敏的真實樣本與正確答案,和天地人一起量測辨識率、設計欄位檢查規則與人工覆核關卡,再決定哪些文件可以自動化。前段的影像整理可以搭配 ImageMagick,覆核流程則可安排為部門內訓。
本文由 TARAISG(TIANDIREN AI SOLUTION GROUP)使用 AI 模型產生正文、整理來源並設計實務工具。方法依據與限制列於文末;案例為明確標示的教學假設。未有具名紀錄時,不宣稱經人工或專家審核。
查看內容製作與更正說明