
AI 工作實務 · AI 科研應用/產業專題
AI Agent 找出抗菌胜肽候選物,距離新藥還有多遠?拆解 Google Antigravity 科研流程
Google Antigravity 協助搜尋 97 胺基酸抗菌候選物,仍在濕實驗驗證。分清計算證據、研究假說與臨床成效。

本文目錄
科研流程為何需要 Agent?問題不是缺少模型,而是工具分散97 個胺基酸候選物,是如何被逐步縮小出來?從電腦推論到藥物,中間還有幾道不可省略的證據關卡?這個案例對非生技企業也有商業價值科研導入應用什麼指標衡量?常見問題企業行動與延伸英文原文、研究與影音當 AI Agent 可以跨資料庫搜尋、讀取研究文獻、比對蛋白質結構,再提出實驗方案,科學家要多久才能找到下一個值得研究的候選物?Google DeepMind 於 2026 年 10 月 15 日展示 Antigravity 的科研工作流程:研究者與 AI Agent 共同搜尋抗菌胜肽(antimicrobial peptide),最後挑出一個由 97 個胺基酸構成、具備結構與基因組證據的候選物。來源 01
但真正值得放在標題後半句的是:該候選物仍在接受濕實驗(wet-lab)驗證。 它不是已證實能治療感染的藥物,更不是已完成臨床試驗的新抗生素。新聞若把「生成與比對一個合理假說」寫成「AI 成功發明新藥」,就跨越了科學證據最重要的一條界線。
科研流程為何需要 Agent?問題不是缺少模型,而是工具分散
蛋白質研究通常必須在資料庫、文獻、序列比對、結構分析、基因組註解與實驗規劃之間反覆切換。這些工作不僅有技術門檻,也存在資料版本、證據標準與不同系統輸出的整合成本。Google 案例中的 Antigravity 並不是單靠模型「猜」出新物質,而是把一連串既有研究工具與資料庫串成可由研究者反覆提問的工作流。來源 01
其中,UniProt 是蛋白質序列與功能資訊的重要公共資源,ProtNLM 用於根據蛋白質序列推測可能的功能描述。這些機制能改善候選搜尋效率,但「被模型預測為某種功能」不等於該功能已被實驗證實;尤其在資料庫中尚缺乏完整人工註解的蛋白質,預測與驗證必須被明確區分。
97 個胺基酸候選物,是如何被逐步縮小出來?
Google 示範由研究者提出目標後,Agent 查詢 UniProt 中的候選序列,找到一個標示為 A0A0U0D591、長度為 97 個胺基酸的 Lactococcin 972 家族候選物。研究者再引導 Agent 使用 BLAST 與人工審核資料庫比對,並查詢 AlphaFold 蛋白質結構資訊,尋找是否存在與已知抗菌胜肽相近的構型。來源 01
下一步,工作流回到基因上下文:候選序列附近的基因是否呈現有意義的組合?若相關輸送與調控基因的位置支持「這是一組可能運作的抗菌系統」,便能提高它值得投入實驗的合理性。注意,這是不同類型間接證據的互相支持,並不是最終有效性試驗。原始 UniProt 條目可由 A0A0U0D591 查看,但編輯本批未能獨立擷取其動態頁面完整內容。來源 02
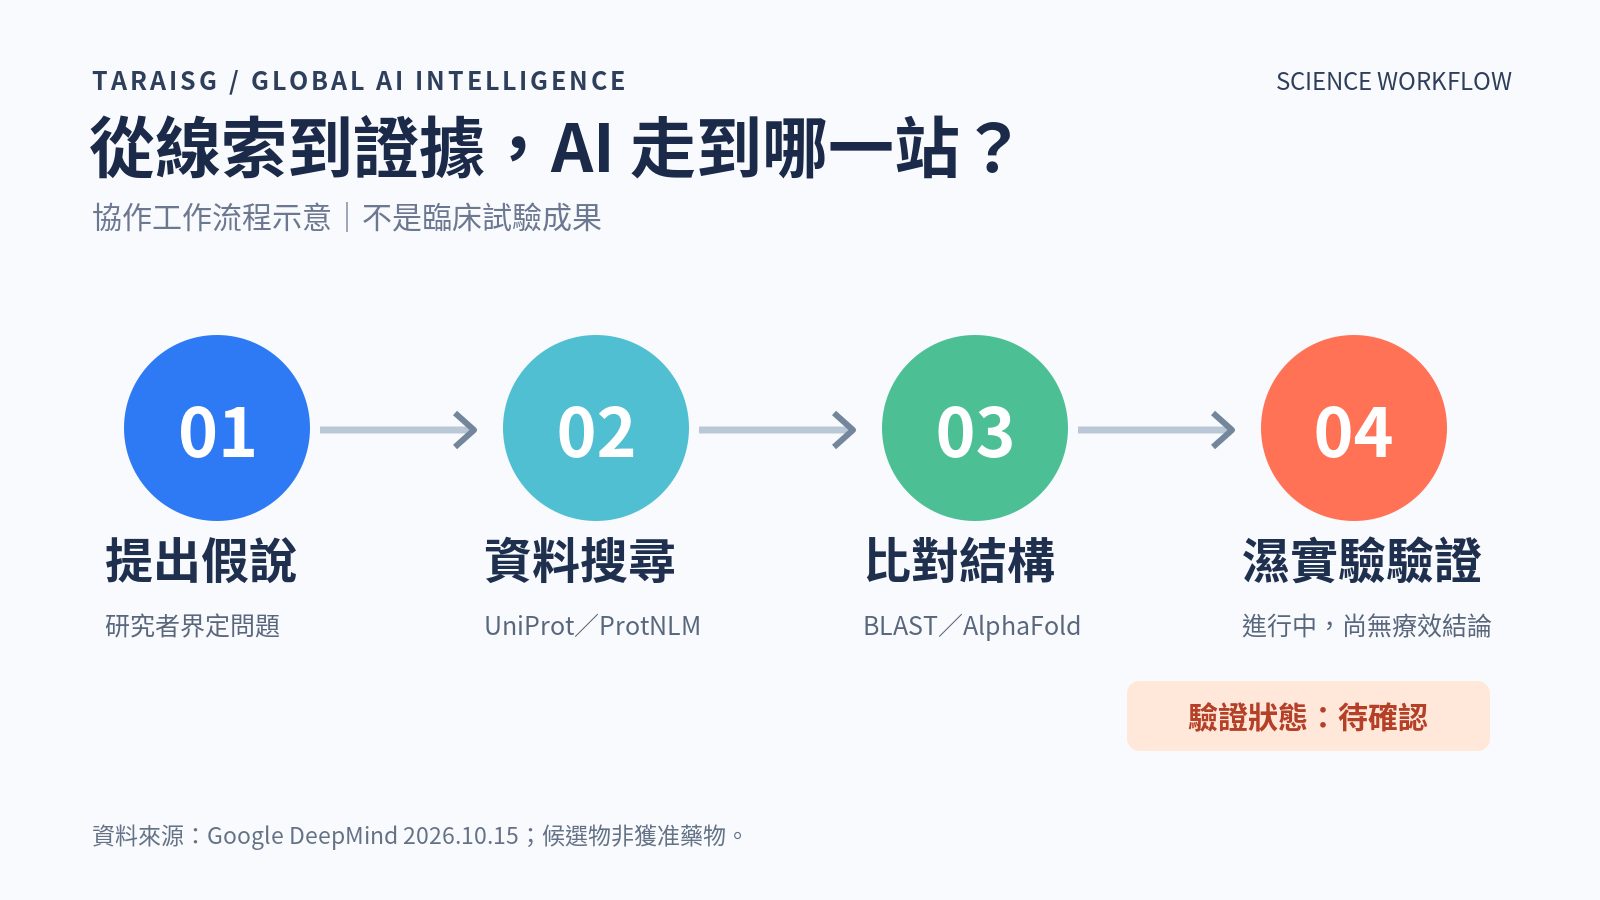
從電腦推論到藥物,中間還有幾道不可省略的證據關卡?
至少需要辨認蛋白質確實有何種抗菌活性、對哪些菌株有效、在不同實驗條件是否可重複、是否有細胞毒性,以及後續體內動物試驗、藥物動力學與臨床研究的要求。不同研發路線規範不一,但共同原則很清楚:電腦模型能幫忙決定優先測什麼,不能取代測量本身。
Google 已明確說明,這個候選物以及其他同流程發現的候選仍處於實驗室驗證階段。來源 01 因此,目前可以報導的是「AI Agent 協助形成更有組織的可測試假說」,不是「新抗生素問世」。若後續出現實驗數據,應以新證據更新本文,而不在今天預支成果。
這個案例對非生技企業也有商業價值
真正值得企業借鏡的,是科研工作流的設計方法。第一,研究者保留目標與假說決定權;第二,Agent 執行跨資料來源查詢、比對與整理;第三,每一步都留有能回到來源的證據;第四,真正重大決策由外部可觀察結果決定。這個模式可延伸到法務盡職調查、採購供應商評估、財務異常分析與企業知識檢索,前提是各產業必須建立自己的資料可靠性與驗收機制。
例如,企業若要求 Agent 判斷某項設備採購是否符合合約條件,可以讓工具搜尋規格表、詢價單、合約版本與歷史交易;但是正式決策仍應要求可追溯的對照表與具名核准。工具整合效率高,不等於每一項比對就一定正確。這也說明為何 Agent 系統需要資料工程、任務設計與人類責任分工,而不是只需要一套新的對話介面。
科研導入應用什麼指標衡量?
不要只看模型提出多少候選。更有參考價值的是每次搜尋的候選覆蓋率、證據完整度、來源版本可重現性、假陽性造成的實驗成本、每個進入濕實驗候選的實際發現率。這些是天地人提出的評估面向,並非 Google 本案例已報告的實證成效數字。
當 AI 加快提出假說的速度,最寶貴的資源可能變成有限的實驗能力與專家判斷時間。因此,真正成熟的系統應先排序候選,而非無限制擴增實驗需求。
常見問題
Q:Google 已經發明新抗生素了嗎? 這次公告沒有提供支持該說法的證據;示例候選仍在濕實驗驗證。
Q:ProtNLM、AlphaFold 是臨床驗證嗎? 不是。它們協助提供功能與結構等計算證據,不等同體外、體內或人體臨床結果。
Q:非生技企業能學到什麼? 可以借用「人決定研究問題、Agent 蒐集證據、專家核對、明確驗收」的可追溯協作結構。
企業行動與延伸
若團隊希望把多個資料庫、文件與工具串成可稽核的 AI 工作流程,可先準備資料來源清單與可驗證的工作成果,透過企業培訓聯絡信箱討論能力建置,而非宣稱課程會教授臨床藥物研發。
英文原文、研究與影音
來源 01 Pengfei Tian 等,Accelerating the search for antimicrobial peptides with Google Antigravity,Google DeepMind,2026/10/15。英文研究示範全文。原文短摘:「The lead identified here is now undergoing wet-lab validation.」
來源 02 UniProt,A0A0U0D591 entry。蛋白質原始資料庫條目。網站使用動態頁面,本批未完成條目本文獨立抽取;97 aa 資料由 S01 報告核對。
來源 03 Google DeepMind 原文頁面內嵌影片,Accelerating antimicrobial peptide discovery with Google Antigravity。官方內嵌影音。未取得可核對逐字稿,不用影片旁白補充未確認的科學結論。
科學候選、電腦推測與實驗實證已在正文區分;編輯研究圖由天地人重新繪製。使用 AI 工具協助製作,未經獨立具名真人或領域專家審閱。
製作、來源檢核與更正方式
- 回到原文:點選文內來源索引,再開啟英文官方原文;以公告/研究日期及原文條件核對,不將舊背景資料當成本週事件。未獨立核對的資料已明列限制。
- 核對數據:比對本文與來源數據 CSV 的期間、樣本、單位、分母及比較基期;官方觀察不自動等於因果關係或所有企業的結果。
- 辨認分析:官方公告、研究結果與天地人提出的企業判斷分開處理。候選物、計算推測、濕實驗與臨床結果不可互換;UniProt 動態本文及影片逐字稿未獨立核對,已在來源段落標示,未據此補充效果宣稱。
- 引用與圖表:英文僅保留必要短引並附來源,其餘以自行撰寫的分析與重新整理的圖表呈現;未轉載來源全文、官方圖片、人物照片或影片逐字稿,不代表取得來源機構背書。
- 提出更正:若發現錯誤、來源更新或權利問題,請來信提出更正,附本文網址、疑義段落與可核對的來源位置。確認修正時應同步更新文字、數據與圖表,保留修訂紀錄。
本文由 TARAISG(TIANDIREN AI SOLUTION GROUP)使用 AI 模型產生正文、整理來源並設計實務工具。方法依據與限制列於文末;案例為明確標示的教學假設。未有具名紀錄時,不宣稱經人工或專家審核。
查看內容製作與更正說明



