
AI 工作實務 · 完整指南・AI 法務工作流程
AI 法務如何真正落地?從合約審閱、法律研究到企業合規的實戰指南
AI 法務怎麼落地?從合約審閱、法律研究、資料保密與台灣及歐盟法規,到工具選型、90 天試點與驗收,附三份工作範本。

本文目錄
一、AI 法務到底是什麼?先分清「用 AI 做法律工作」與「管理 AI 法律風險」二、為什麼法律工作最適合文字 AI,卻也最容易錯得有模有樣?三、先看工作流程,再決定買哪種工具四、法律研究的專業能力,在於會建立「證據鏈」五、AI 合約審閱不是找關鍵字,而是建立可以談判的決策表六、AI 法規監測要分清「新聞、草案、公布與生效」七、2026 年台灣《人工智慧基本法》公布後,企業真正要做什麼?八、個資、營業秘密與保密義務,不是一張「不拿來訓練」聲明就能解決九、歐盟 AI Act 的時程已經改變,台灣企業不能沿用舊版簡報十、AI 生成合約、圖片和教材,誰有著作權?十一、五種適合 AI 法務的工作場景,以及各自的停損線十二、為什麼有法律資料庫與 RAG,仍然會回答錯?十三、如何挑選法律 AI 工具?不要先看廠商排行榜十四、怎麼做一個有用的 POC,而不是一場看起來很成功的展示?十五、示意案例:標準 NDA 如何從人工往返,變成可控的初審流程?十六、示意案例:法務與外部律師如何運用 AI 協作而不模糊責任?十七、企業應建立怎樣的 AI 法務權責矩陣?十八、法律 AI 供應商契約,不能只審價格和責任上限十九、90 天導入計畫:從一個場景,建立可擴充的工作方法二十、教育訓練不是教大家寫 Prompt,而是讓不同角色知道什麼時候該停下來二十一、AI 法務的 KPI 怎麼設計,才不會誘導錯誤行為?二十二、AI 法務事件應變:錯誤意見發出後,組織如何知道該怎麼辦?二十三、AI 法務不能取代律師,與 AI 法務仍有巨大價值,並不矛盾二十四、法務部門如何建立「可用資料」?知識庫治理比模型大小更重要二十五、法律 AI 的驗收題庫怎麼建?別只測答案好不好看二十六、從合約送審到簽核,如何定義 AI 的真正權限?二十七、法規監測不只是訂閱新聞:如何從公告變成可執行的義務清冊?二十八、企業在採購 AI 法務服務之前,可以如何算出真實成本?二十九、可直接複用的三份工作範本:把原則寫進每天的案件三十、常見問題:企業真正開始用 AI 法務前,最需要釐清的八件事結語:法律部門真正應該擴大的,不是 AI 產生的文字量參考資料與查核說明圖片與素材說明導讀:把一份保密合約交給生成式 AI,幾十秒後可能得到一份看起來完整的審閱意見。然而,這份意見是否對應正確的契約版本、適用法域與公司的風險偏好?工具讀取資料是否獲得授權?如果漏掉責任限制條款,誰會發現、誰負責?企業導入 AI 法務,真正要回答的不是「AI 寫得有多快」,而是「速度提升後,我們是否仍能追溯依據、發現錯誤並明確決策責任」。
資料查核日期:2026 年 10 月 21 日。 本文以台灣企業法務與法律工作者為核心讀者,並討論跨境業務可能涉及的歐盟規範。文中情境、範本與建議僅供一般管理與教育參考,不構成個案法律意見。文獻以 [S01] 等編號對應文末官方或原始來源。
一、AI 法務到底是什麼?先分清「用 AI 做法律工作」與「管理 AI 法律風險」
一家公司說要做 AI 法務,採購部門可能開始找軟體,法務長關心準確率,資訊主管擔心資料外洩,經營者期待合約更快簽好。這些要求都合理,但不是同一層問題。沒有共同定義,專案容易在試用時表現亮眼,真正進到日常工作流程卻遇到權限、資料、責任與簽核障礙。
第一種意義是 Legal AI,使用人工智慧協助法律及法務工作,例如契約條款辨識、歷史版本比對、法條檢索、訴訟資料整理、法規變動監測與企業法律知識問答。第二種意義是 AI 法律風險管理,由法務部門協助企業評估部署 AI 時涉及的個人資料、營業秘密、著作權、採購合約、責任分配與跨境義務。前者關心法律工作如何做得更好,後者關心企業使用 AI 是否有適當的治理與合法依據。
兩種工作相互影響,但不能混為一談。公司可能已有可以整理合約的模型,卻沒有全公司的 AI 使用清冊;也可能寫了厚厚的 AI 管理政策,但法務仍每天透過電子郵件追著業務補交易資料。真正可持續的成果,是先把一件法律工作定義成可重複、可驗收的流程,再把資料治理和風險控制設計在流程裡。
美國律師協會在 2024 年的 Formal Opinion 512 討論生成式 AI 在法律研究、契約審閱與法律文件草擬中的用途,同時提醒律師要注意專業能力、保密、與客戶溝通、監督及合理收費等適用的倫理義務。這是美國專業倫理意見,不是台灣律師的直接法源;對企業管理者的啟示是,專業責任不會因為把一個步驟交給模型而消失。[S01]
因此,本文主張以五個條件衡量 AI 法務:資料取得合法、來源可追溯、輸出可驗證、決策權責明確、異常可以回報。只要缺少其中一項,系統即使能快速回答,也不應被視為已完成正式法律工作。
二、為什麼法律工作最適合文字 AI,卻也最容易錯得有模有樣?
法律實務充滿長文本,契約、法規、裁判、函釋、會議紀錄和法律意見都需要大量閱讀。大型語言模型善於處理語意、找出相近表述、整理段落與生成文字,看似很適合。工研院曾從合約條款、構成要件與情境辨識的角度說明 AI 協助合約分析的技術方向,顯示這不是單純的聊天工具概念。[S15]
可是法律文本的風險,常藏在讀得懂之後。同一條賠償條款,供應商與採購方對它的接受度不同;同一句「不得洩露」,涉及機密研發資料與一般業務聯絡資料的法律與商業影響也不同。法律工作至少包含事實整理、文本解釋、法律適用和商業判斷。AI 可以協助前兩類的初步作業,後兩類尤其需要適用法域、具體事實與授權人判斷。
所謂「幻覺」不只指完全虛構的判決,也包括引用真實存在卻不支持結論的條文,把舊法當成新法,把外國規則誤套台灣,或把例外規定省略。史丹佛研究團隊對特定法律檢索工具進行實證評估,發現受測產品仍會出現法律幻覺,研究摘要指出受測工具的比例超過 17%。這是特定產品、題目與研究時點的結果,不能推論所有 AI 法律工具或台灣法規資料庫的錯誤率。[S02]
一份看起來非常完整的回答可能說:「依某法第 X 條,契約雙方可以在十五日內處理。」真正驗收必須核對法規名稱、條號、修法時間、適用對象、事實條件和例外。若無法開啟官方原文,這只是尚未驗證的文字,而不是能直接簽核的法律結論。把「文字通順」誤認為「法律可靠」,正是 AI 法務最大的管理陷阱之一。
三、先看工作流程,再決定買哪種工具
企業的第一個 AI 法務專案,常被設定成「把公司所有合約都交給 AI 審閱」。這種範圍過大,因為合約類型、法域、附件、風險、內部授權和交易條件都不同。最好的起點通常不是先買一套功能很多的平台,而是找出一個高頻、標準化、錯誤可控的工作單元,例如標準保密協議的第一輪檢核。
應先畫出一份契約從業務送件,到法務確認,再到主管核准與簽署的完整流程。若文件往返的主因是資訊缺漏,即使模型一秒完成摘要,也不會解決等待業務回覆的問題。若契約每次都找不到最新版本,改善文件管理可能比導入更大型的模型重要。這是第一性原理:法律工作的價值是讓交易在可承擔風險內完成,並不是讓文字產生速度最大化。
接著訂出 Contract Playbook,把公司的條款立場和審批權限寫清楚。每個欄位至少包含適用契約種類、偏好條款、可以接受的替代寫法、不能接受的情況、需要補充的事實與升級對象。例如,一般 NDA 可以由指定法務審閱,但一旦涉及未公開原始碼、特殊個資或重大責任上限,可能需要主管或外部律師介入。具體門檻必須由公司依風險和授權制度訂定,不能從網路範本直接複製。
AI 的輸出不應只是「此份合約有風險」。更有價值的是列出條款原文位置、所屬主題、與公司準則的差異、可能影響、待補資訊,以及目前能否給出結論。如果附件缺失或法域不明,系統應能表達「無法判斷」,而不是被要求對所有問題都給出確定答案。最後由授權審閱者決定是否接受、協商或升級,並留下決定與依據。
這個流程可以幫企業辨認真正需要的系統:只是收件、分類和提醒,或是具備精確版本比對的合約 AI,還是完整合約生命週期管理系統。工具名稱應在需求確認後才出現,否則科技投資容易變成流程問題的昂貴繞路。
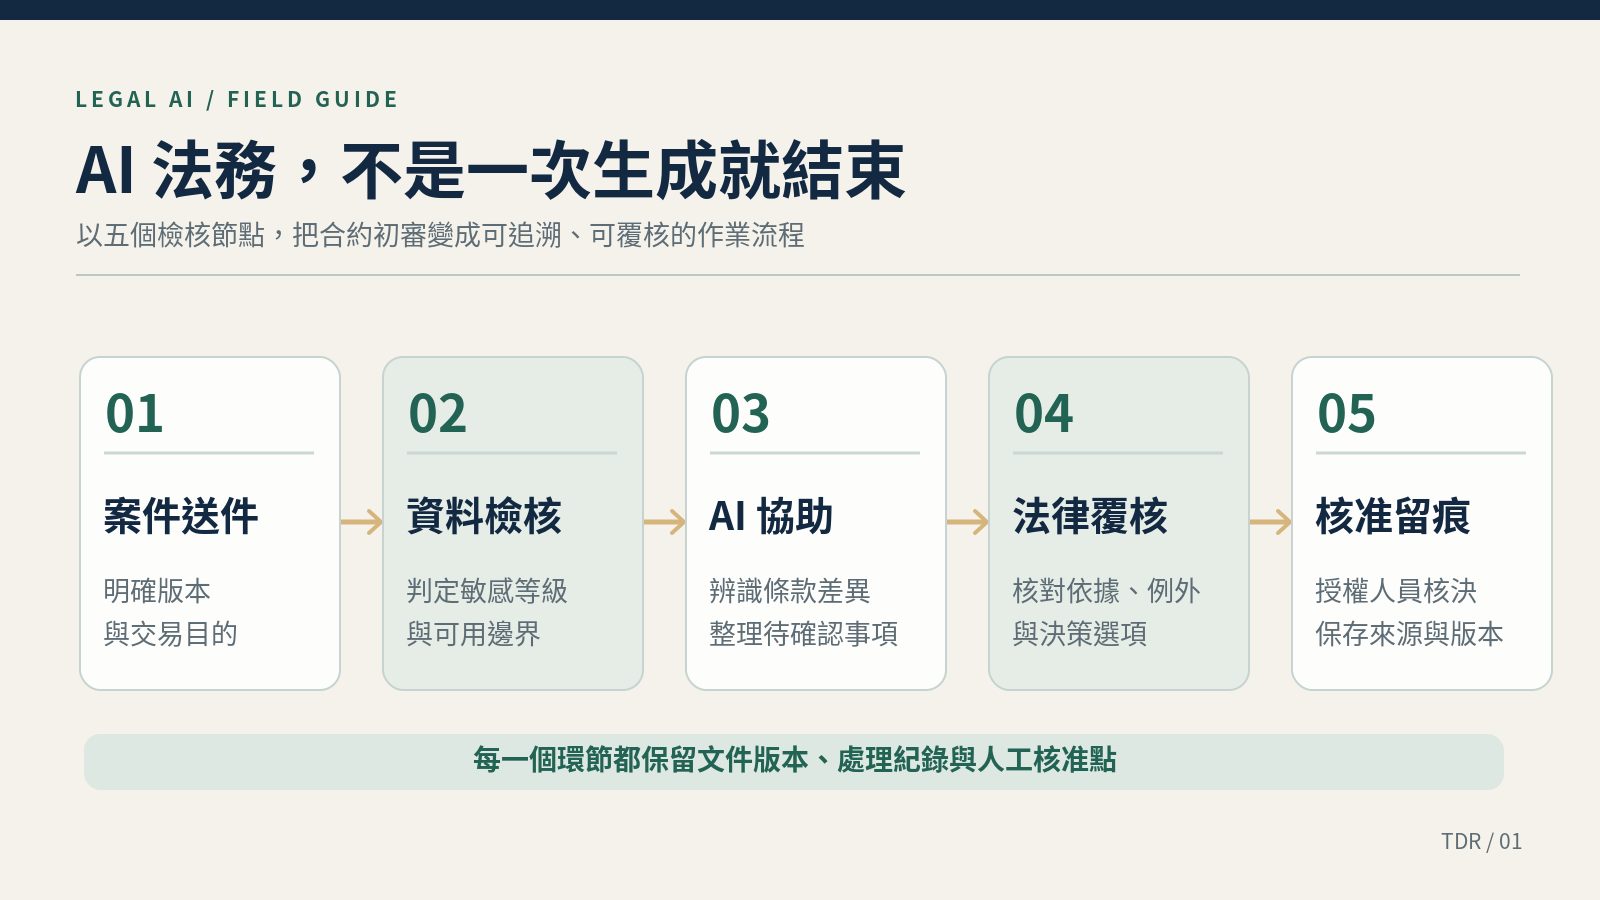
圖 1:原創管理流程示意,從送件、資料分類、AI 輔助、法務驗證到核准與留存。並非法規規定的固定工作程序。
四、法律研究的專業能力,在於會建立「證據鏈」
法律研究不是請模型寫一篇完整的意見就結束,而是將「問題、事實、來源、法律分析與結論」連成可以由另一名人員重新核對的工作成果。缺少證據鏈時,主管可能看不出哪個段落是法條原文、哪個是模型推論,或結論是否受文件中的假設限制。
實務上可以使用六欄研究記錄。第一欄是明確的法律問題;第二欄是已核實的事實;第三欄是尚待確認的事實;第四欄列出法規、裁判或官方解釋的原始連結與版本;第五欄說明如何將事實對應要件;第六欄記錄結論、風險和核准者。最好讓每個重要句子都能指向確定條號、文件段落或正式資料來源。
例如業務問:「我們可以把客戶名單交給 AI 幫忙分群嗎?」這不是只查到一個個資法條就有答案。法務先要知道名單的內容、原蒐集目的、使用者角色、AI 提供者是否處理資料、會否跨境、分群結果是否被用來拒絕服務,以及原本是否已有合法的委外或授權安排。AI 最適合先協助整理需要補問的事實,再搜尋適用規定,而不是在缺乏情境時立即表示合法。
台灣法規應回到全國法規資料庫、主管機關公告與可核實的裁判資料,確認公布、修正及施行狀態。若模型提出的案號找不到,或存在的裁判書沒有說出模型宣稱的論點,應標記為「未經核實」並移除,不可用二手網誌替代原始查核。跨國法律研究還需分辨法律、行政指引、標準、產業建議與研究論文,它們的拘束力不同。
好的 AI 法律研究報告也必須容許不確定性。法律會隨時間變動,證據可能彼此矛盾,不同國家的規定未必能直接比較。將未決問題揭露出來並指定下一步確認者,比產出一段貌似確定的結論更符合專業工作要求。
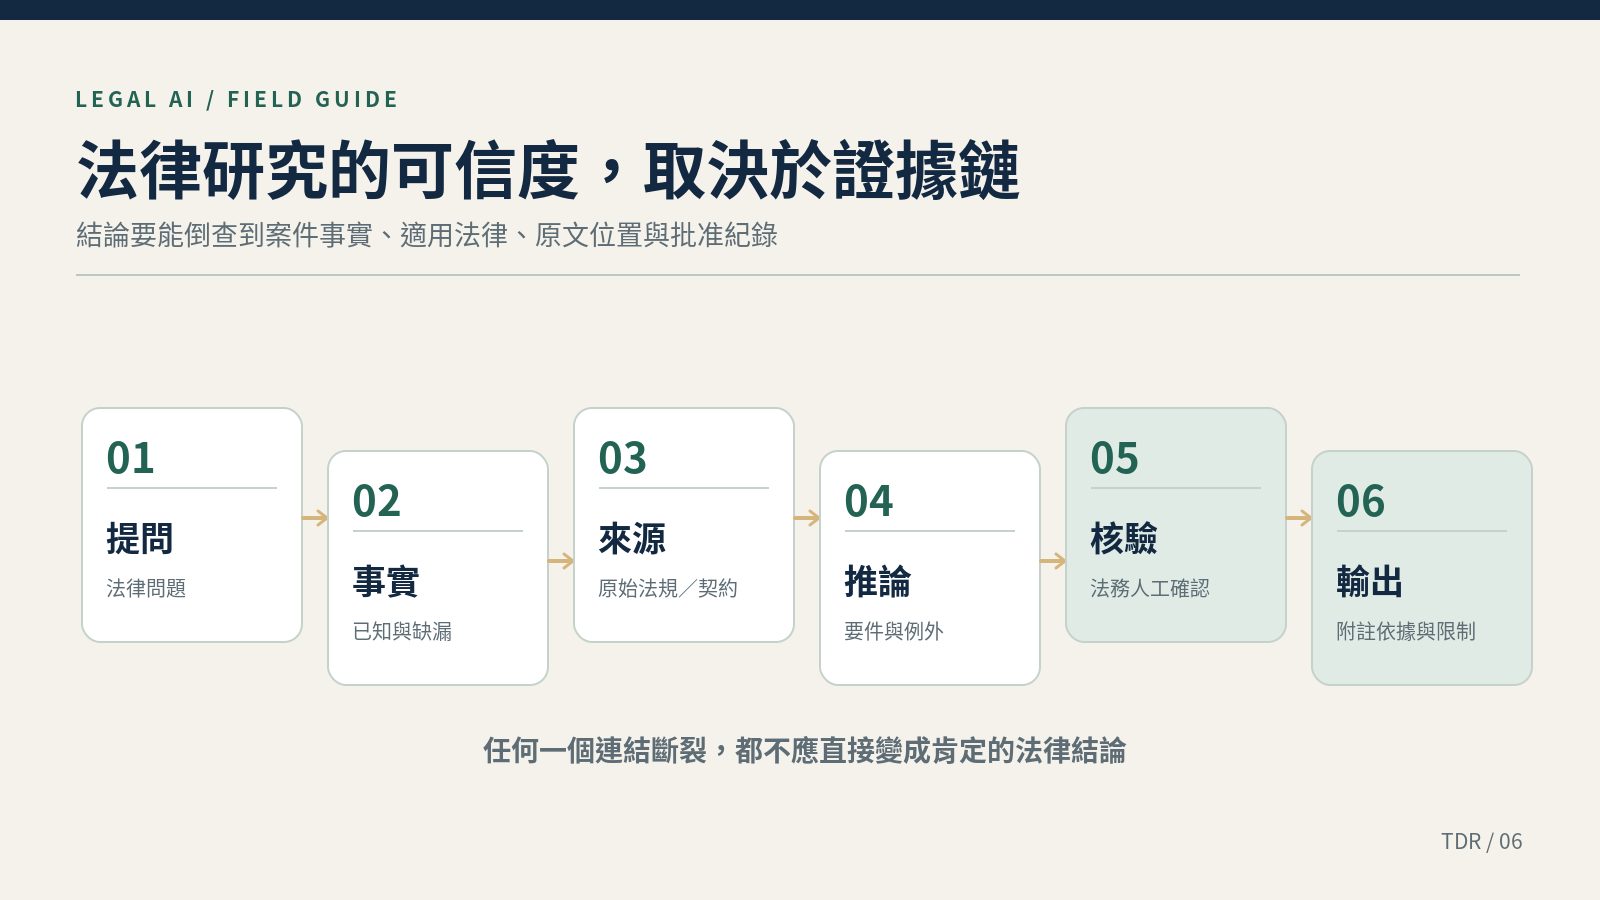
圖 2:原創法律研究查證流程;供企業設計內控參考。
五、AI 合約審閱不是找關鍵字,而是建立可以談判的決策表
「AI 能找到責任限制條款」只是最初級的能力。條款本身的風險取決於適用的法律、前後文、定義、例外、付款安排與交易角色。例如對方要求無上限的間接損害賠償,不同規模、不同業務類型與不同合作目的的公司,對風險的承受程度可能完全不同。AI 不知道企業的風險政策,就不可能替企業做完整決定。
所以 Playbook 的每個主題都要寫出商業目的與法律判斷。例如資料處理協議可以檢查資料用途、當事人角色、分包、處理地區、稽核、事件通知、終止後刪除及責任分配;但這些只是風險識別與協商欄位,不是每個國家與每筆交易都必須有完全相同條款,也不是檢核表打勾便代表合法。真正適用的要求仍須由法務依資料性質和業務條件確認。
AI 的建議應分為事實、風險和選項。例如:「第 8 條允許收受方將資料提供給關係企業,但文件未顯示關係企業的保密義務如何承接;可能增加內部資料流向不明的風險;建議請業務確認預計提供對象,並由法務決定是否要求義務連帶或補充限制。」比起「第 8 條高風險,請修改」,這種輸出才能讓業務理解問題,也讓法務選擇談判策略。
契約審閱的成效最終要放進商業情境。若系統只會把所有條款變成紅色警示,業務可能覺得法務更難合作。若它能明確標出哪些是格式問題、哪些需要業務補事實、哪些只能由主管承擔,它反而能讓組織更快區分可立即處理與需要決策的案件。法務的角色不是把交易擋住,而是在界線內支持交易完成。
六、AI 法規監測要分清「新聞、草案、公布與生效」
企業法遵常追蹤主管機關新聞、修法草案、公報、法規與解釋令。生成式 AI 可以協助摘要和建立提醒,但最大的風險是把某項政府提議當成今天已開始執行的法律義務。法規監測不能只保留標題,應獨立記錄提案、通過、公布、施行、過渡期及後續子法或配套的狀態。
2025 年台灣《個人資料保護法》修正提供了很好的示例。全國法規資料庫顯示,2025 年 11 月 11 日公布的部分修正、增訂與刪除條文,施行日期仍由行政院定之;截至本篇查核時,官方資料仍標示部分條文尚未生效。不能因為最新版本頁面顯示第 27 條刪除,就直接推論現行義務已消失。[S05]
法遵監測表建議包含:法規或文件名稱、主管機關、地區、正式版本、公布日期、施行日期、影響業務、負責窗口、待處理事項與查核連結。狀態至少分成「已生效且需處理」「已公布但未生效」「仍為草案或徵詢」「僅為指引或意見」。如果某法規仍待主管機關發布子法,應註明該部分尚未確定,不應先為企業推導虛構的強制表單或罰則。
一份好的週報不會只是轉貼新聞。它應回答:我們哪個產品受到影響?今天有什麼行為必須調整?若目前尚無確定義務,何時回頭查一次?哪個部門負責蒐集事實、哪位法務主管判斷?把情報變成「影響、責任、期限、證據」,才是真正有管理價值的法遵工作。
七、2026 年台灣《人工智慧基本法》公布後,企業真正要做什麼?
台灣《人工智慧基本法》於 2026 年 1 月 14 日公布,依第 20 條自公布日施行。它已經是法律,不能再描述成尚未完成立法的草案。法律第 3 條定義人工智慧,第 4 條提出政府發展 AI 的治理原則,第 16 條要求數位發展部推動 AI 風險分類框架並協助各目的事業主管機關訂定以風險為本的規範,第 18 條涉及政府檢討相關法規與行政措施。[S03]
理解基本法時最關鍵的是辨認條文的義務主體。例如第 19 條規定政府使用 AI 執行業務或提供服務時須進行風險評估、規劃措施及建立內控,不能未經解釋就擴張為每一家民間企業一律必須完成相同形式的認證。另一方面,第 16 條又意味著企業應關注本身所屬主管機關後續制定的產業規範,而不能因為基本法包含政策性文字,就忽略既有個資、商業秘密、消保與契約法律。
企業可以先建立 AI 使用清冊,逐筆記錄用途、使用部門、處理資料、受影響對象、可能產生的損害與人工監督方式。這是符合風險管理邏輯的實務建議,不代表每一項欄位已被基本法直接規定為所有民間企業的強制義務。若某個系統影響招募、授信、健康或重要權益,應提高法律與管理審查的強度,並另行確認特別法或主管機關規範。
法務向管理者報告時,可將發現拆為「已生效且適用」「已公布尚待配套」「屬自願性最佳實務」「仍待主管機關解釋」四類。這比單純告訴企業「AI 法來了」更有價值,因為經營者需要的是今天該停止、調整、記錄或投入資源的哪一件事。
八、個資、營業秘密與保密義務,不是一張「不拿來訓練」聲明就能解決
法務工作常處理的資訊不僅敏感,而且可能受到不同制度保護。契約可能含員工姓名、客戶聯絡資料、尚未公開的定價和產品規格、訴訟策略或交易條件。這些資訊可能同時涉及個人資料、營業秘密、契約保密或特定的職業責任。不能因為工具商保證「不使用輸入資料訓練模型」,便推論所有資料處理與移轉都合法。
台灣《個人資料保護法》第 2 條涵蓋直接或間接可識別的自然人資訊;第 5 條涉及目的與必要範圍等基本原則,第 6 條對特定敏感個人資料另有規定和例外。若把姓名換成編號但其他內容仍可間接辨識當事人,未必脫離個資概念。[S05] 企業需追問蒐集目的、資料使用方式、委外角色、授權、跨境處理與安全措施,而不是只討論文字是否匿名。
《營業秘密法》第 2 條以非一般知悉、具有經濟價值、所有人採取合理保密措施等條件定義營業秘密。[S06] 因此,企業需要確定哪些資訊屬於重要的未公開資料、誰有存取權、能否向第三方服務揭露,以及如何留存保密管理證據。不是所有內部文件都自動成為營業秘密,但已經很敏感的商業資料不應在缺乏風險評估時隨意進入外部系統。
供應商盡職調查至少要問:原始檔、提示詞、回答與系統日誌分別存放何處?誰可以讀取?是否用於任何再訓練或服務改善?保存期限和刪除方式是什麼?是否有次處理者?發生事故如何通知?能否隔離不同客戶資料?企業採購的方案是否與公開產品介紹不同?這些答案需要正式文件或契約佐證。
此外還有間接提示詞注入的問題。惡意指令可以隱藏在待審閱合約、郵件或檢索文件裡,企圖讓 AI 執行原本不應執行的工作。OWASP 將提示詞注入與敏感資訊揭露列為 2025 年版 LLM 重要風險,也提醒 RAG 不能完全消除提示詞注入。[S11][S12] 因此,公司不只要教同仁不要洩密,也要在系統層設計存取控制、輸入隔離和工具權限限制。
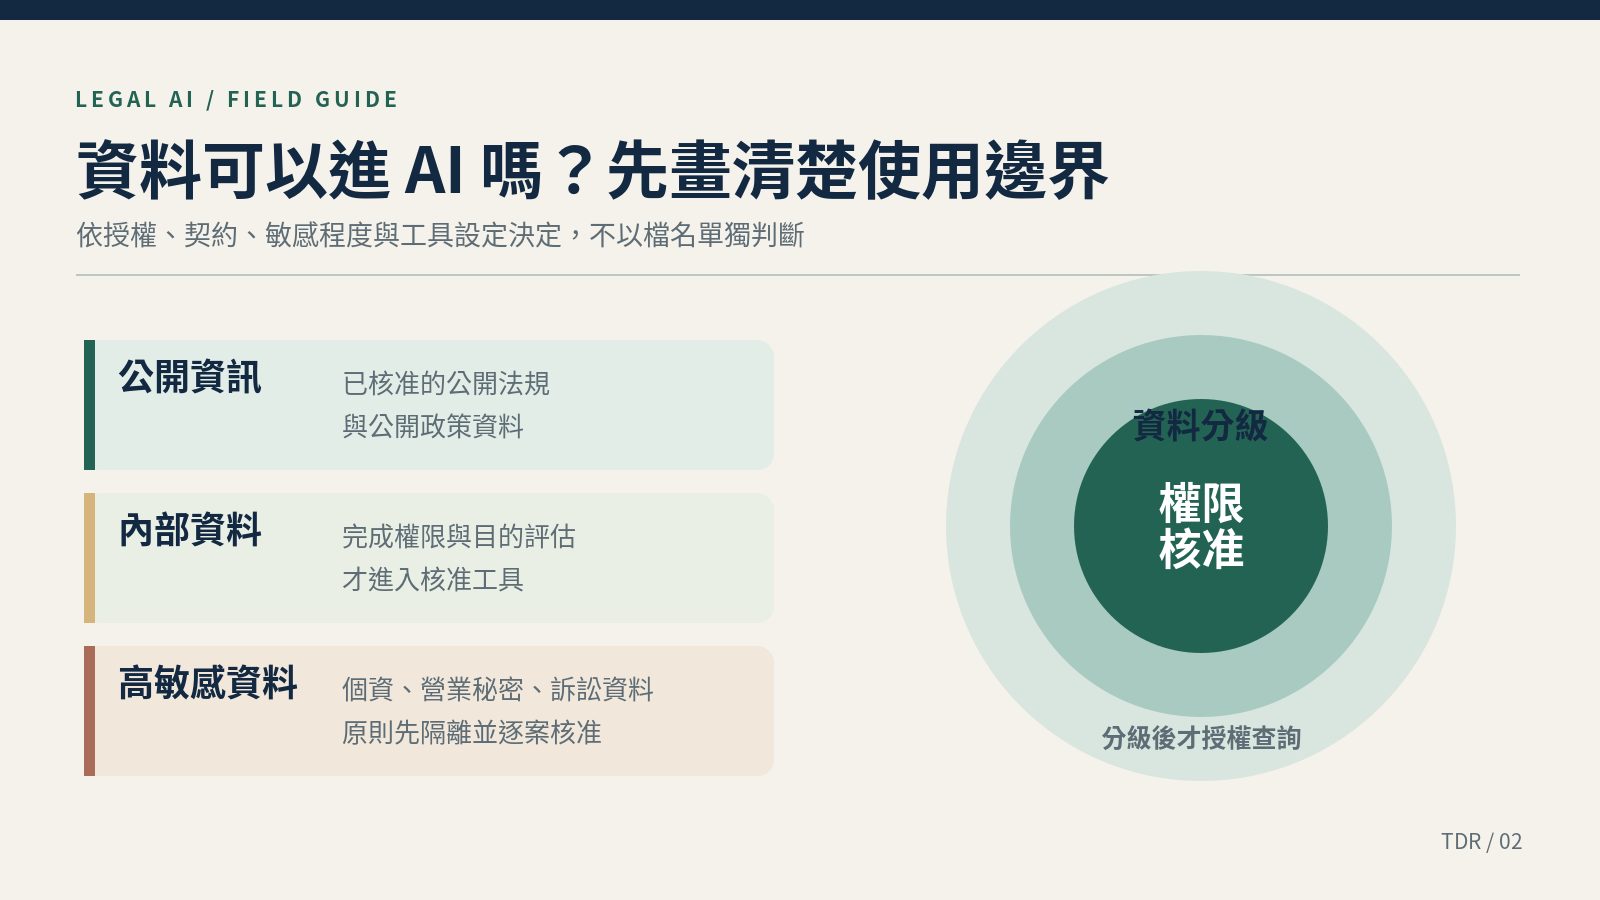
圖 3:原創資料處理分流圖。資料分類與核准門檻應依各企業政策調整,不能當成法定分級。
九、歐盟 AI Act 的時程已經改變,台灣企業不能沿用舊版簡報
歐盟《AI Act》經常被簡化成「所有使用 AI 的企業都需要立即取得認證」。這是很危險的理解方式。它區分供應者、部署者、進口商等不同角色,並依用途、風險類別和適用地區設定不同要求。尤其對台灣企業而言,即使沒有在歐盟設立公司,也不等於所有 AI 應用都不會涉及歐盟規則。官方第 2 條涵蓋某些位於第三國但其 AI 系統產出在歐盟使用的供應者及部署者,實際仍需逐項判斷條文要件。[S16]
2026 年的重大變化是,歐盟通過 Digital Omnibus on AI,修正規則於 2026 年 7 月 27 日生效。依歐盟官方現行實施時程,2025 年 2 月 2 日起適用部分一般條款與禁止性規範,2025 年 8 月 2 日起適用通用目的 AI 模型相關義務,2026 年 8 月 2 日起適用大部分其餘規則。附件 III 某些高風險 AI 用途規範改至 2027 年 12 月 2 日適用,附屬於受管制產品的某些高風險系統則至 2028 年 8 月 2 日。不同過渡規定仍可能影響具體個案。[S04]
因此,台灣企業先要做的不是填滿一份放諸四海皆準的「歐盟認證清單」,而是知道自己的系統在法規中扮演哪一種角色。公司若只是讓法務查詢公開資訊,和把 AI 產品提供給歐盟客戶使用,所需檢查的問題不同。公司若利用 AI 評估求職者、協助決定客戶資格,與只是整理會議紀錄,也不能採取同一個合規範本。法律義務要從具體用途與法定分類出發,不是從模型名稱推導。
修正後的《AI Act》第 4 條仍然要求供應者及部署者採取措施支持相關人員 AI 素養,並考慮人員的知識、經驗與實際使用情境,但不要求保證每個人達到某一個固定程度。第 50 條則對特定人機互動與 AI 生成內容設定透明性或標示要求,也存在針對用途、內容性質與人工審查的例外。不能簡化成「任何 AI 文字都必須標示」或「做完一次教育訓練就自動合規」。[S17][S18]
對有歐洲業務的企業,法務可以維護四張互相關聯的台帳:產品及使用地區、使用者與供應商身分、系統用途與風險分類、義務與證據。若判斷仍有爭議,應列出所需法律意見,而非在表格裡先把不確定內容改成「合規」。AI 在這裡可以支援文件彙整與變更提醒,但真正的適用性判斷需要有明確的責任人。
十、AI 生成合約、圖片和教材,誰有著作權?
企業法務經常遇到一個表面簡單的問題:「我們已付費訂閱 AI 產品,生成內容是不是全部歸公司?」這裡至少存在三件不同的事。第一是供應商合約允許使用者如何利用輸出;第二是輸出本身是否具備著作權保護要件;第三是人類創作部分,依法律、僱傭或委外契約,應由誰享有權利。把三件事混成一句「已買商用授權」,可能讓未來的素材使用與證明陷入困難。
台灣智慧財產局曾解釋,若完全由 AI 演算自行生成、沒有實際人類創意投入,相關內容可能欠缺著作權保護;若 AI 只是輔助工具,實際創作者仍投入符合保護要件的創意,該人類創作部分則有可能受到保護。2026 年 7 月 24 日的解釋還談到 AI 協助製作簡報,以及僱傭關係下的職務著作歸屬,提醒權利應依創作過程和約定判斷。[S07]
這也表示,不能只因為生成的圖像看起來獨特,就宣稱它一定可以由企業排他主張;同樣地,也不能認為只要使用過 AI 就一概失去著作權。著作權保護的是符合法定要件的創作表達,不是訂閱帳號的付費紀錄。若產生爭議,具體的人類創意投入、產製過程和契約安排都可能成為關鍵。
另一層風險是輸入與輸出可能涉及第三人權利。把他人的文章、教材或設計上傳給 AI 改寫,先要判斷是否取得必要的利用權;生成結果與其他受保護內容有實質近似時,也可能發生侵權問題。智慧財產局已在個別解釋中提示,AI 生成課文或文章供商業使用,仍不能完全排除涉及他人著作權的風險。[S07]
實務上,法務可要求對重要對外素材保存原始創意、授權素材清單、實際人工修改記錄、模型使用條款的版本及發表前審核紀錄。這些措施不能保證沒有侵權爭議,卻能讓企業在需要回溯權利來源、調查申訴或移交著作時,有比「這是 AI 做的」更可靠的資料基礎。
十一、五種適合 AI 法務的工作場景,以及各自的停損線
第一種是契約資訊結構化。 企業可能累積大量歷史合約,卻無法快速知道哪些即將續約、哪些含有特殊保固、哪些約定自動調價。AI 可以協助從可合法處理的契約中抽取主體、日期、金額、義務與原文位置,再交由人工抽驗。停損線是:若掃描品質不足、關鍵附件缺失、無法對應原文,不應把抽取結果直接當成契約義務的唯一依據。
第二種是標準契約初審。 例如 NDA、例行採購文件、一般服務條款。企業先訂出 Playbook,再由 AI 標記缺漏與偏離,減少重複閱讀。停損線是:特殊跨境條款、重大侵權賠償、實質交易結構、未授權的敏感資料或複雜法域衝突,要交由法務主管或執業律師評估,不能用標準化模型的風險標籤直接放行。
第三種是法律研究輔助。 AI 可以整理問題、指出要查證的規定、彙整不同來源,減少在大範圍材料中找線索的時間。停損線是:任何法條、裁判、行政函釋或法律結論,若不能由可靠原始來源核實,不能直接寫入正式意見、訴訟文書或對外信件。研究回答應有引用與適用日期,不只是漂亮的摘要。
第四種是內部法律知識問答。 業務可能反覆詢問哪種情況需送法務、哪份 NDA 是最新版、誰能核准特殊折讓條款,這些問題可以由經核准的政策、文件庫與內部規則回答。停損線是:當問題含有個案爭議、新型交易或不在政策範圍內的情況,系統應轉交人員,而不是創造一套原本不存在的公司政策。
第五種是全公司 AI 風險盤點。 法務透過使用清冊掌握哪些部門採用模型、輸入何種資料、供應商條款如何、產出是否影響個人權益,並提醒法規與契約變更。停損線是:系統只能協助取得資訊和提醒,不代表已自動完成具法律效果的內部稽核或主管機關申報。
要決定哪些工作值得自動化,應同時評估五個維度:結果錯誤的法律後果、資料敏感程度、是否容易驗證、人工修正能否及時完成、工作步驟是否穩定。越容易驗證、風險越容易控制的任務,越適合先試;反之,如果結果涉及不可逆轉的重大權益決定,就需要把人類核准留在正式流程裡。不要以「AI 能不能做」取代「組織該不該交給它做」。
十二、為什麼有法律資料庫與 RAG,仍然會回答錯?
RAG(檢索增強生成)的基本作法,是從指定來源檢索相關內容,再由模型根據檢索材料生成回答。它有助於回傳較具體的來源,特別適合企業自己的契約庫與經授權使用的知識文件。但即使系統聲稱「只根據公司資料回答」,也不能因此推論答案百分之百正確。
錯誤可能出現在四個不同階段。第一是來源:資料已過時、掃描辨識錯誤,或有附件沒有收錄。第二是檢索:系統找出了相似但不適用的條文、另一國法律或已失效版本。第三是生成:模型在看見正確資料後仍可能省略重要限制,把不同段落拼成一個超出原文的主張。第四是引用:答案附有真實存在的網址,卻沒有任何段落支持它的推論。
史丹佛針對特定法律檢索工具的研究提醒,資料檢索與生成結合不能消除幻覺。[S02] OWASP 則從資訊安全角度指出,檢索流程仍可能收到含惡意指令的文件,藉此操縱後續模型行為。[S11] 兩者不是同一種問題:前者是答案真實性與法律判斷的風險,後者涉及系統是否把不可信資料當成指令的權限邊界。
要改善這些問題,企業應為文件建立清楚的 metadata,包括文件識別碼、標題、版本、擁有者、適用地區、發布與生效時間、存取權限、保留期限、最後核對日。AI 檢索回覆最好能指出條款段落或頁碼,而不是只貼首頁連結。若資料彼此衝突,系統應呈現衝突與需要確認的地方,不應自動把不同版本混成單一答案。
品質驗收至少要將「檢索是否找對文件」與「生成的答案是否受到文件支持」分開檢查。法律 AI 不是一般聊天機器人,它的關鍵價值在於當另一名審閱者打開相同文件時,可以驗證同一項主張。即使 AI 只扮演資料找尋助手,也應留下來源和審核紀錄。
十三、如何挑選法律 AI 工具?不要先看廠商排行榜
法律 AI 工具大致可分成通用文字助手、法律研究平台、契約條款審查、合約生命週期管理、內部知識系統及企業專屬部署。不同類型的架構與優勢不同。法律研究平台可能強在法規及裁判搜尋,契約管理平台可能強在流程與提醒,通用助手可能更適合低風險的文件整理。不能只用「是否有 AI」或「功能數量」判斷哪一套最好。
法務選型第一個關口應是資料處理與保密條件。必須檢查企業實際採購的產品版本與書面合約,而不是只看產品網站。供應商能否說清楚提示詞、附件、輸出和日誌的保存方式?是否允許不同客戶的資料隔離?能否約束分包與支援人員的存取?能否提供完整刪除或資料轉移流程?若這些條件不足,產品展示再漂亮也不應直接處理真實敏感案件。
第二個關口是台灣法域和繁體中文適應性。國際品牌可能在美國或歐洲法律資料上有良好表現,仍不代表能處理台灣法規、裁判用語及雙語合約。應建立自己公司的測試題目,測試法條版本、條款位置、引用支持性、掃描辨識、修訂痕跡與各種不完整資料。刻意安排幾個無法回答的問題,觀察系統是否懂得停止。
第三個關口是工作流程整合。法務可能每天在 Word、SharePoint、契約管理系統、電子郵件及簽核平台之間工作。如果 AI 的結果還需要人員大量複製貼上、失去修訂歷史或無法對應最新版本,雖然模型回答很快,整體業務未必更快。實際評估應從業務送件一路計時到正式完成,而非只看生成回覆的幾十秒。
第四個關口是總持有成本。除了訂閱價格,還有資料整理、串接、內部資安審查、模型評估、教育訓練、人工複核、事故處置和更換供應商時的移轉成本。企業若每月契約量不大,先改進收件表單與 Playbook 可能更划算;若有大量重複契約,專用平台才更有機會展現價值。這不是對單一廠商的結論,而是合理的投資評估順序。
選型會議應讓法務、資訊安全、資訊工程、採購與實際使用部門一起參與。由法務定義何謂正確、哪些結果不能接受;由資安確認可否處理資料;由資訊工程確認系統整合與可維運性;由業務說明真正需要的回覆時間。只有將能力測試放在公司自己的任務中,採購決策才不會被產品簡報牽著走。
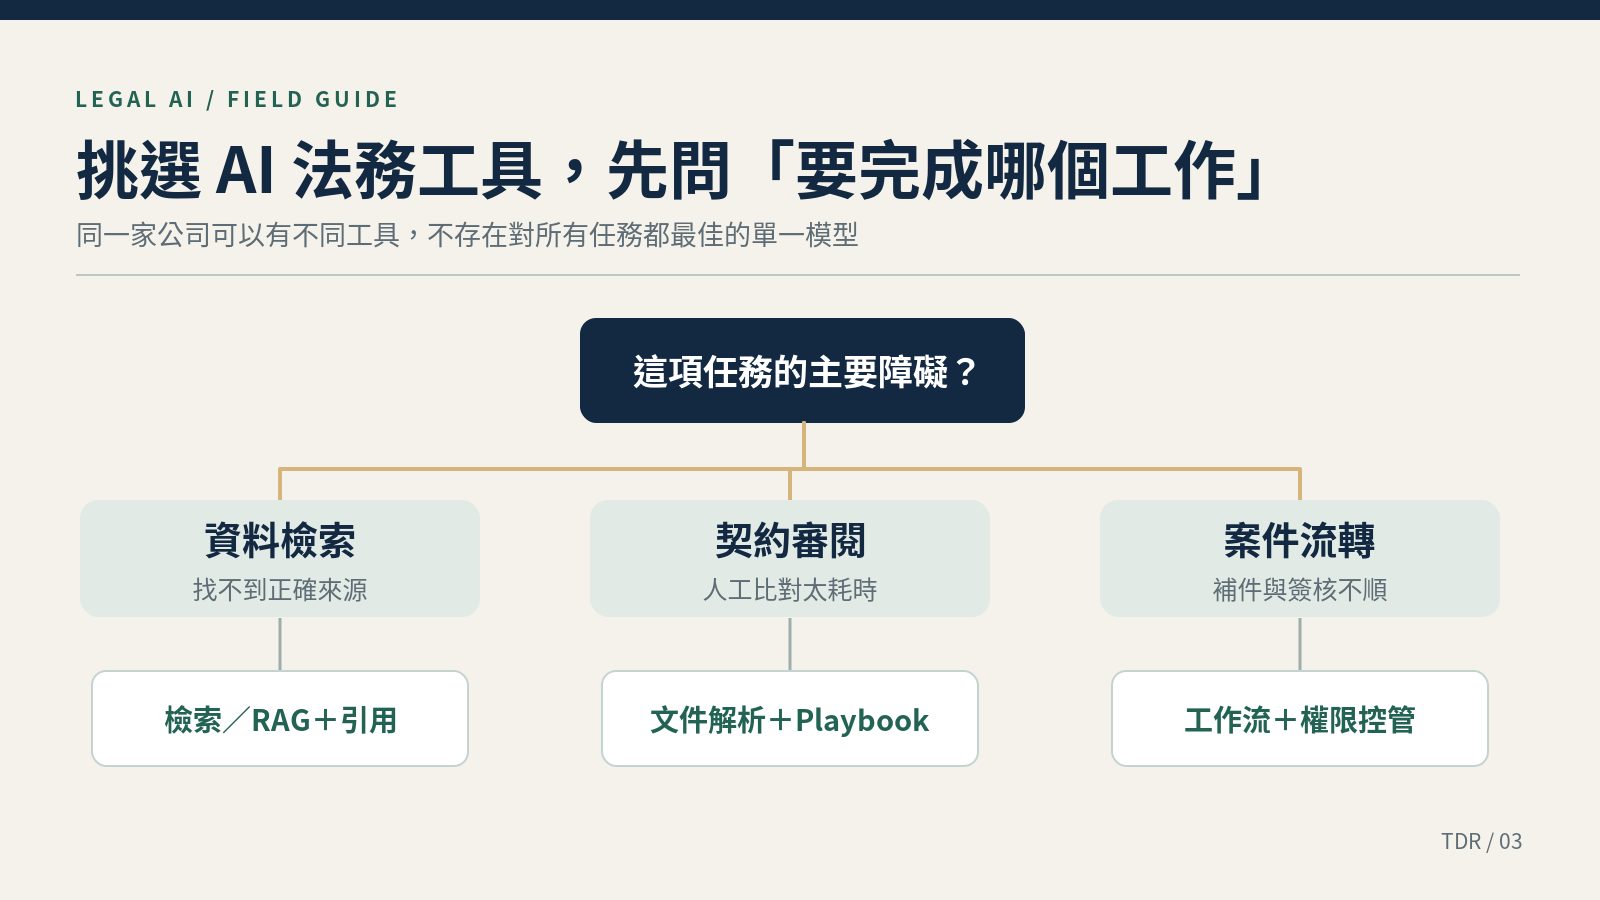
圖 4:原創決策示意。優先檢查資料授權、實際任務與驗收能力,不是商用法律工具的名次評比。
十四、怎麼做一個有用的 POC,而不是一場看起來很成功的展示?
許多 POC 只拿十份格式整齊的文件請工具產生摘要,然後由主管看成果。這能展示系統會生成文字,卻很難證明它能進入正式法律流程。真正的試驗需要驗證錯誤、例外、可追溯性、資料安全與整體時間,而不是只蒐集令人滿意的答案。
先由具權限的法務人員建立合法測試集,必要時去識別化,且保留人工確認過的參考答案。資料至少分成一般、困難、對抗與邊界四組。一般組測試標準條款,困難組測試掃描檔、雙語、修訂軌跡和缺頁附件;對抗組測試虛構引用、文件內惡意指令和互相矛盾的版本;邊界組則要求 AI 面對不具足夠資訊的案件時標記待確認或交由人員處理。
成果也不能只記一個「準確率」。風險辨識至少要衡量漏報和誤報,法律研究要檢查引用存在、來源支持、版本有效與法域正確。流程評估應計算業務送件到完成的總時間、人工複核時數、退件補資料比例、升級案件比例,以及發現錯誤後可否查清原因。若系統將每個條款全部標為高風險,看似不會漏掉,反而會讓法務處理大量誤報。
2026 年 Thomson Reuters Institute 針對法律、稅務、會計、風險及政府等領域超過 1,500 名受訪者的研究摘要指出,18%的受訪專業人士表示其組織有追蹤 AI 投資報酬率。這不是台灣法務的獨立比例,卻提醒我們,普及使用與有效衡量不是同一件事。[S09] POC 結案時應把測試條件、成功與失敗案例、人工評語及改善項目一起呈報,不能只留下廠商宣稱節省了多少時間。
測量時間更要避免不合理對比。若把「AI 在三十秒內產生初稿」與「法務以往兩小時完成所有驗證與審批」放在同一張圖,就是比較不同工作範圍。真正應比的是,在相似的案件和相同品質要求下,AI 輔助流程是否讓完整任務更快完成。即使試驗沒有證明效率提高,只要揭露了資料缺漏、審閱門檻或工具不適用情境,也是一個能支持管理決策的結果。
十五、示意案例:標準 NDA 如何從人工往返,變成可控的初審流程?
以下是虛構情境,不是天地人的實際客戶案例,也沒有聲稱任何可核實的節省比例。一家企業軟體公司經常與潛在合作夥伴簽署雙向保密協議。過去業務把 PDF 直接寄給法務,法務開始審查後才發現交易目的、資料類型、時間壓力與合作方身分不明,因此必須多次寄信詢問。經營者原本以為瓶頸是「法務看得太慢」,真正問題卻可能是送件內容不完整。
改善方案首先是一張有用的收件表單。業務必須說明交易目的、對方公司、是否涉及未公開技術、是否包含客戶個資、合作地域、希望簽署日期,以及是否曾使用其他版本範本。第二步由法務訂定 NDA Playbook,讓 AI 可比對保密資訊定義、揭露例外、用途限制、責任、期限、刪除義務、準據法與爭議解決等項目。真正的接受範圍與升級門檻要由這家公司的法務及管理階層決定。
第三步,系統只協助讀取與比較。它標記相應條款、列出偏離公司立場之處、提示文件是否缺頁,並記錄待確認事項。第四步由法務檢核,對可以接受的標準差異提出明確處置;涉及高度機密資料或重大責任的條款則升級。第五步再將核准意見回覆業務,並把最終版本、核准者與簽署資訊寫回台帳。
在這套設計裡,AI 最重要的功能可能不是「寫得像律師」,而是讓每個人知道資料該交給誰、何時可以往下走,以及遇到例外必須停在哪裡。業務因此不需要等待一份無法預測時間的黑箱答案;法務也能把注意力留給真正有商業影響的特殊條款。
同時,這個方案有明確界線。若 NDA 實際上連帶包含資料授權、開發成果歸屬或重大投資承諾,就不能依「表單類別是 NDA」而套用標準審閱。分類錯誤可能比文字生成錯誤更危險,因此流程應保留讓審閱者重新定義案件的權限。
十六、示意案例:法務與外部律師如何運用 AI 協作而不模糊責任?
企業導入 AI,並不意味應該消滅外部法律服務。大量例行文件的瓶頸常是查找和分類,重大跨境爭議的瓶頸則是專業法律判斷、談判經驗和責任承擔。AI 讓雙方更容易整理問題,卻不代表法律意見的授權與責任可以交給一個不具法律主體地位的模型。
假設一家台灣製造業準備與海外客戶簽署授權及保固契約。內部法務先利用經核准的 AI 工具比對談判版本、分類風險並列出缺少的事實;業務補上出貨地、產品用途和保固流程;外部律師再針對準據法、強制規定、責任分配與可執行性提供法律意見;內部法務將意見整理成管理者可以選擇的談判方案。如此可以降低資料傳遞時的資訊散失,而非宣稱機器已代替律師判斷。
雙方應事前確認資料能否交由 AI 系統處理、是否涉及委任契約限制、權限如何設置、引用由誰核實,以及交付成果如何標記。美國 ABA 的 Formal Opinion 512 提醒使用生成式 AI 的律師注意保密、能力、溝通與費用等倫理問題,但這些意見仍應依實際執業地法令和個案判斷,不能被直接搬成台灣法定規則。[S01]
外部律師接手時,最有價值的是一份已整理好的法律問題單,而不是一堆未經查核的模型建議。問題單應包含:交易背景、具爭議的原文、商業目標、目前建議、不能接受的風險、需要特別詢問的法律問題。這樣的協作保留了誰提供資料、誰提出法律分析、誰核准商業選項的清楚界線。
十七、企業應建立怎樣的 AI 法務權責矩陣?
企業不太可能由法務部門單獨管理全部 AI 使用,因為模型涉及資訊安全、業務流程、資料庫、採購、對外服務與員工管理。若任何問題都送法務批准,法務會成為新瓶頸;若任何人都能自行採購工具,組織又很難知道資料去哪裡、錯誤由誰承擔。比較務實的做法是建立跨職能、按案件風險運作的權責矩陣。
經營管理層應訂定風險承受原則和重大例外的核准路徑。法務負責將適用法律、契約限制、保密與知識產權疑義轉成判斷條件;資訊安全負責資料分類、身分與存取控制、系統測試和事件應變;資訊部門負責整合、版本與技術維護;使用部門則對工作需求、提供的事實和實際結果負責。這些角色可以因企業規模而由同一人兼任,但功能不能憑空消失。
權責矩陣至少應列明五種情境。當員工想用新的 AI 服務時,誰可以先試用?當涉及客戶資料時,誰確認授權與委外條件?當 AI 產生與法條相衝突的結果時,誰能停止使用並修正?當企業要對外發布 AI 生成內容時,誰確認權利和誤導風險?當供應商更新條款或新增資料處理地區時,誰重新進行評估?這些問題一旦有實際簽核人,政策才不會停留在公告裡。
台灣司法院在 2026 年 4 月 22 日函頒適用於司法院及所屬機關人員的 AI 使用參考指引,明確要求公務使用時對未經核准系統的機密資訊等建立界線,且核心審判判斷仍由法官負責。它的適用對象不是一般民間企業,也不能被直接當作企業法務的法定內規;但「用途區隔、核准工具、專業判斷留在人身上」的原則,提供了值得參照的治理設計。[S08]
美國 NIST 的 AI RMF 1.0 以 Govern、Map、Measure、Manage 四個功能組織 AI 風險管理。它是自願性框架,不是台灣強制法律。企業可以借用其管理邏輯:先決定誰治理,再辨識使用情境及影響,量測失敗與風險,最後處置、追蹤並改進。[S10] 不需要把一份大型國際框架照單全收,而要使它能對應自己公司的實際流程。
國際標準 ISO/IEC 42001:2023 另從「人工智慧管理系統」角度,提供組織建立管理框架的參考。它是管理系統標準,不等於台灣或歐盟的 AI 法律,也不意味只要採用框架就自動符合所有產業規範;本篇僅根據 ISO 公開介紹提及其定位,並未取得付費標準全文。[S13]
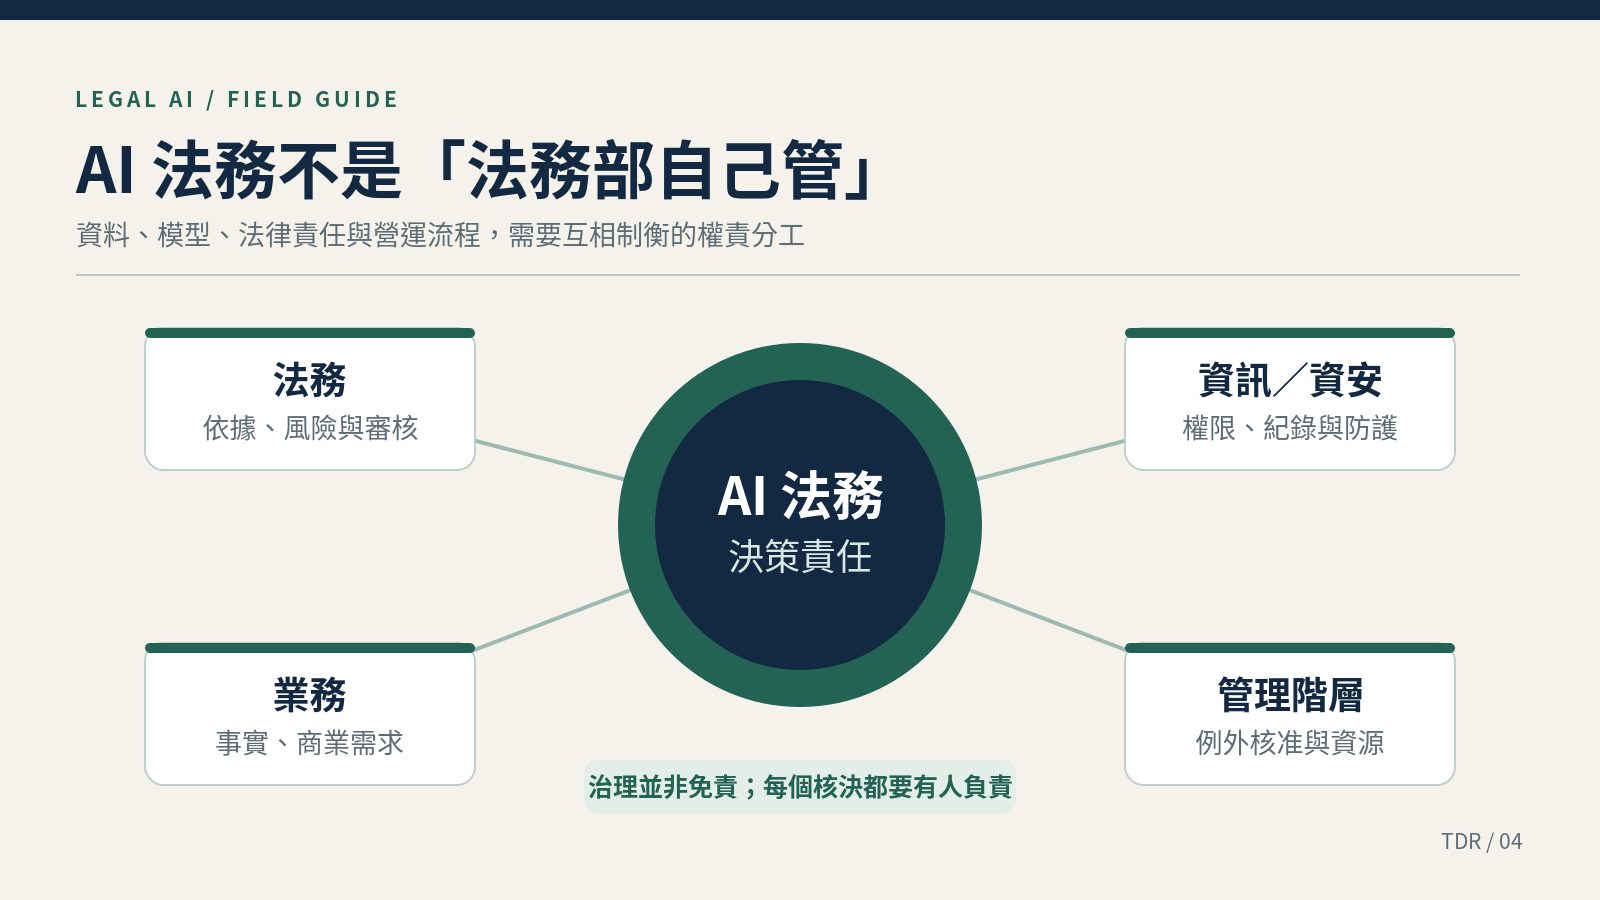
圖 5:原創治理責任示意。將業務、法務、資訊安全、資訊部門與授權主管連接至具體決策,不表示法律上固定的組織編制。
十八、法律 AI 供應商契約,不能只審價格和責任上限
採購一般雲端軟體時,企業常先看帳號數、費用、服務水準與資訊安全認證。採購法律 AI,這些要素仍重要,但應額外注意契約能否對應法律工作真正面對的資料和責任。系統可能處理客戶案件、尚未簽約的商業交易、員工資料甚至準備對外提交的法律文字。這使得供應商的資料使用條款與事故處理能力,可能比行銷展示的模型效果更重要。
第一個應查的領域是授權資料使用範圍。供應商能否基於服務以外的目的使用原始文件或輸出?能否將資料提供次處理者?是否可能將內容用於模型訓練或人工標註?不能只把網站上的「我們重視隱私」視為具體承諾。第二個領域是安全措施及稽核資料,包括加密、權限、日誌、資料隔離、備援、刪除與資安事件通知。實際要求要和資料分類及適用法域相符。
第三個領域是輸出與法律工作責任。工具商是否承諾某種產品功能?是否清楚揭露來源覆蓋範圍、法規更新頻率、系統限制與重大故障通報方式?企業若使用它處理具高度法律後果的工作,要如何定義驗收、不符合時的救濟,以及因產品缺陷或安全事故產生爭議時的通知和合作?不能以通用 SaaS 服務條款就假設已完成專業場景的風險分配。
第四個領域是可退出性。當供應商變更定價、停用功能、資料所在地、服務模型或解約時,公司能否取得自己的文件、分類與工作紀錄?是否有一致且可移轉的格式?會不會因為所有審閱決策只存在一個供應商介面,導致未來無法重建案件歷史?退出條款不是只為了避免被綁約,也是在保護法律流程的證據完整性。
最後,契約審閱不能脫離廠商技術文件、資安測試與內部政策。法務可以要求供應商提出資料流圖與保留政策,資訊部門確認實際技術設定,使用部門驗證工作功能。只有三方看到的是同一個服務版本,契約承諾才有機會轉成可執行的管理控制。
十九、90 天導入計畫:從一個場景,建立可擴充的工作方法
企業若要真正導入 AI 法務,可以採取 90 天的試行節奏,但90 天是本文的建議管理週期,不是法定期限,也不是保證所有公司都能在此時程導入完成。核心不是急著上線,而是每一階段都要有可以驗收的交付物和停止條件。
第 1 至 15 天:確認問題。 蒐集近期送審案件和法務常見詢問,區分文件閱讀時間、往返等待、版本搜尋、法律研究、批准延宕等真正瓶頸。選擇一個高頻、可合法取得測試資料、失敗後果可控的場景。形成工作流程圖、風險與資料清單,以及由主管確認的成功標準。這個階段的輸出不是一張廠商比較表,而是需求定義。
第 16 至 30 天:建立公司準則與測試資料。 整理經授權的契約範本,建立 Playbook、正反面案例、需要升級的情況、資料處理規則和可供核對的參考答案。若發現歷史文件沒有完整版本、原始授權不明、敏感資料無法取得測試許可,就必須先處理資料問題,不應把它藏在模型選型之下。此階段最有價值的資產,是即使不使用 AI 也可改善法務作業的準則庫。
第 31 至 50 天:進行工具與資安驗證。 以相同資料測試候選方案,記錄引用、漏報、誤報、例外處理、可操作性、資料權限與實際人工作業成本。法務、資安與資訊部門共同決定哪些問題足以阻擋試行。測試不應為了支持既定採購方向而調整題目;若工具沒有達到需求,可縮小適用範圍,甚至取消導入。
第 51 至 70 天:小範圍真實作業試行。 在已確認可使用的資料與工具範圍內,選擇實際承辦者,要求所有輸出經人工審閱,記錄處理總時間與缺漏。流程需保留撤回、修訂、例外升級及報告管道。這階段最容易出現的是使用者為了方便跳過結構化送件,或把模型的摘要當成已完成的法律審閱,因此訓練與主管追蹤比展示更多模型功能重要。
第 71 至 90 天:評估擴大或停止。 比較導入前後的完整工作成果、錯誤、返工、使用者負擔與成本,重新審視 Playbook 是否需要修改。主管可以選擇持續一個場景、延伸到相近契約、加強資料治理或停止專案。決策依據應寫進報告,包括不採用的理由與剩餘風險,而不是只留下一個「導入成功」的簡報封面。
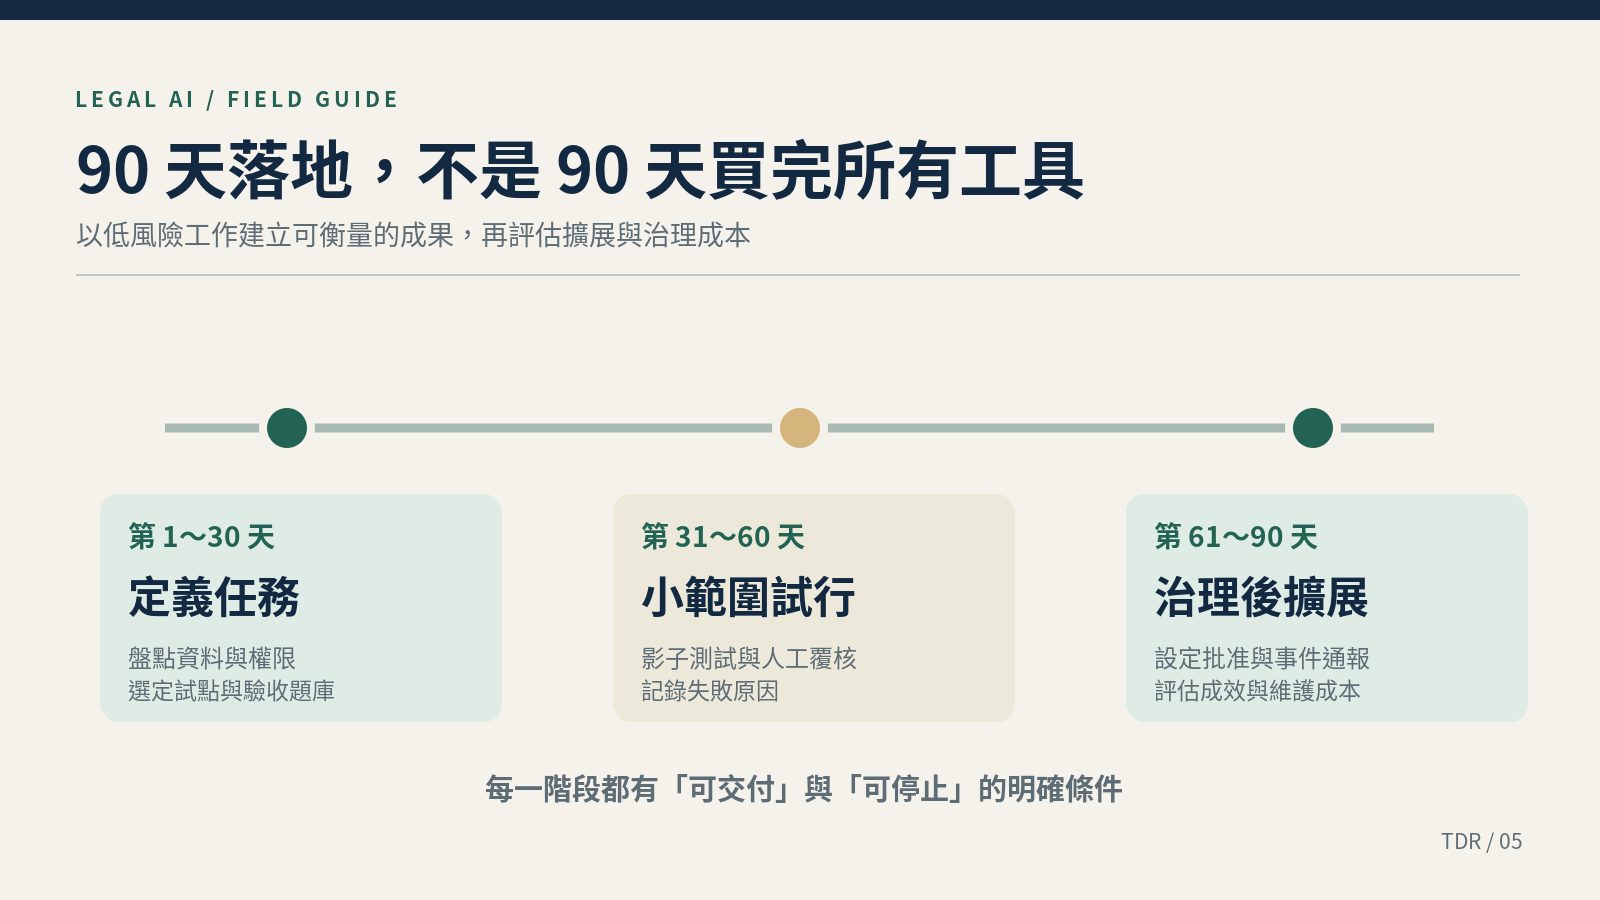
圖 6:原創管理建議時間軸,表示階段依賴關係。時間是示意規劃,並非調查統計或法定要求。
二十、教育訓練不是教大家寫 Prompt,而是讓不同角色知道什麼時候該停下來
很多企業的 AI 訓練停留在介紹介面、展示常用提示詞與示範生成內容。這些技能有其作用,但不夠支撐法律工作。因為法務人員在真實環境遇到的問題往往是:文件能不能上傳?使用哪一個版本?引用資料查不到怎麼辦?AI 對某條款說法和資深律師不同,該採信誰?這些都需要與專業判斷及內部流程結合。
對業務人員,訓練重點是完整送件、辨識敏感資料與理解升級條件。應讓業務知道哪些問題可以用核准的公司知識庫自行查詢,哪些必須將事實和原文交給法務。對法務人員,重點是來源查證、版本比對、證據鏈、異常標示與契約風險解釋。對主管,重點是法律建議和商業選擇的分界、授權核准與失敗後果。對資訊與資安人員,重點是權限、資料流、檢索安全、供應商條款與稽核機制。
實作教育應採案例而非單純操作考試。例如提供同一份經許可的保密協議,讓業務填寫送件資訊,法務建立審查問題,AI 提供第一輪差異,主管判斷是否能談判,最後資訊人員核對資料處理紀錄。每個人都看到別人的工作如何影響自己,才能避免「AI 導入」被當成某個人的個人效率工具。
考核也要圍繞工作結果,而不是提示詞寫得多長。學員是否能找出一個不存在的法條?是否會對未知事項標記待確認?能否指出敏感資料不可進入未經核准工具?是否能把一段冗長的法律問題翻譯成業務可執行的選項?這些能力才是法律場景中的 AI 素養。
對具有歐盟適用情境的業務,還需針對 AI Act 現行第 4 條的 AI literacy 要求做具體的法規適用評估,不能只因為上過一般 AI 課程就假定完全符合所有義務。[S17] 培訓紀錄可保留教材版本、角色、案例、測驗與改善項目,供內部持續調整。訓練不是專案結束的點綴,而是保證工作者知道系統邊界的重要控制措施。
二十一、AI 法務的 KPI 怎麼設計,才不會誘導錯誤行為?
如果主管只要求「合約審閱時間減半」,法務可能減少必要的複核;如果只要求「高風險條款檢出數」,AI 可能把正常內容都標紅;如果只要求「每人每天使用 AI 次數」,員工就可能為了達標而產生沒有實際用途的問答紀錄。績效指標會改變行為,所以法律 AI 的 KPI 應同時觀察效率、品質、風險與採用情形。
效率可以衡量完整工作週期,包括從案件收件到可對外回覆的總時間、等待補資料的時間及法務實際處理時間。這三種時間要分開,否則系統讓閱讀加快,卻沒有改善等待的情況,會被誤認為整體效率提升。品質可以觀察人工確認後的重大漏報、誤報、返工及來源引用正確性。風險則應記錄未經授權上傳、版本錯誤、權限異常及需要升級的案例是否按照規定處理。
採用率也要有意義。最好衡量「符合條件的案件中,有多少按經核准流程處理」,而不是單看登入次數。新工具使用率很高,但正式簽核仍要人工重做一遍、沒有留下任何決策紀錄,就不能算完成流程整合。高頻使用的系統也不一定最好;如果它持續產生錯誤,退出率和人工補救成本更值得主管關注。
對投資報酬率,應盡量同時算出增量成本與真正節省的可用工時,而不是只把模型回答時間轉換成金錢。節省的工時若沒有轉成案件處理量增加、外部費用合理化或更好的服務品質,財務價值仍需要進一步檢驗。某項工作即使沒有節省很多時間,只要能顯著提高重大例外的可見性,也可能值得保留,但理由要清楚記載,而非隨意換算成巨大營收。
最重要的管理原則,是建立品質門檻先於效率獎勵。若系統存在尚未處理的重大資料洩漏風險或法律引用錯誤,就不能因為節省大量時間而繼續在相同範圍使用。績效報告應同時讓管理者看見收益與負面結果,並記錄每次改善之後的測試版本。
二十二、AI 法務事件應變:錯誤意見發出後,組織如何知道該怎麼辦?
導入規畫常把重心放在如何讓 AI 工作,卻很少先想好它出錯之後的處理方式。法律場景的異常可能包括:虛構法條被寫進正式函件、應保密的契約被送到未核准系統、錯誤的文件版本被交付、員工引用一段過時規則做出不當決策,或供應商發生安全事件。這些問題不能只靠重新生成一份較好的答案解決。
企業應定義事件通報路徑。首先是立即限制受影響的輸出或權限,視實際狀況暫停相關功能;第二是保全必要紀錄,包括輸入的來源文件版本、模型及檢索設定、輸出內容、操作人與發現時間;第三是由法務、資安和業務負責人判斷資料、客戶或決策是否受到影響;第四是確認有無適用的通知、補正、契約或主管機關義務;第五是修復並進行回歸測試。
需要特別注意,「立即停用某項 AI 功能」與「刪除所有紀錄」並不相同。若涉及事故調查或履約爭議,可能需要依法及依公司政策保存必要證據;另一方面,也不能以調查為理由無期限保存所有敏感資料。這裡需要法務與資安共同設計適當的保存範圍、存取與刪除程序。
生成錯誤也應分層。一般的格式錯誤可以由承辦者修正;引用不實但尚未對外使用的情況,應記錄失敗樣本並修正流程;已對外發出且可能影響重要權益的內容,需要由責任主管判斷是否撤回、更正、通知或尋求外部法律意見。不同事件的法律後果不同,不宜以一個固定的「所有問題 24 小時內結案」規則概括。
管理者最需要的是每個事件都能回到設計缺陷:錯誤來自未更新資料庫、檢索不準、使用者不理解邊界、提示詞注入、審批失效,還是本來就沒有定義責任人?根因不同,改善方式也不同。把事件當成個別員工「沒有小心使用 AI」而不檢討系統設計,往往只會讓相同問題再次出現。
二十三、AI 法務不能取代律師,與 AI 法務仍有巨大價值,並不矛盾
科技討論常陷入兩極:不是認為 AI 即將全面取代律師,就是認為模型有幻覺因此不應碰法律工作。這兩種說法都忽略了任務分工。法律服務包含大量可分解工作,像是檢索、整理、版本比對、格式化與提醒,也包含不能被簡化的事實認定、策略選擇、專業責任及對當事人權益的判斷。
美國 FTC 對 DoNotPay 所謂「機器人律師」的行銷主張採取執法行動,2025 年完成一項禁止無依據宣稱可替代專業服務等內容的命令。這項事件發生在美國消費者保護的特定事實背景,不應直接轉換成台灣所有法律 AI 服務的違法判斷。它的教訓是,法律科技的商業承諾不能超過已證實的能力。[S14]
台灣司法院的 AI 使用參考指引也反映相近的專業界線:AI 可以協助資料檢索、摘要和作業流程,但證據價值、事實認定、法律適用及量刑等核心判斷仍由法官親自執行。[S08] 企業法務雖然不是司法院及其所屬機關,仍可從這種區分理解,哪些工作適合輔助、哪些必須保留授權人的責任。
更成熟的問題不是「AI 能否像律師一樣回答」,而是「企業能否把人工專業投入最有價值的部分」。例如讓新人用 AI 找出合約歷史版本,讓資深法務集中處理重大風險;讓業務用知識庫找到正確送件規則,讓法律部門減少反覆解釋同一份政策;讓法規監測系統自動分類公告,讓專業人員專注判斷真正產生義務的變更。這些都是可驗證、較務實的收益。
同時要明確告知使用者:AI 工具不是法律意見的責任主體,不能因為文字有法律語氣就當成執業律師的個案建議。對外正式法律文件、涉及權益的重大決策與訴訟行動,仍需要適用法域中具相應資格和責任的人員審閱。認清界線並不妨礙創新,反而能讓企業更安心地擴大適合的用途。
二十四、法務部門如何建立「可用資料」?知識庫治理比模型大小更重要
企業第一次建立法律 AI 知識庫時,很容易以為只要把所有 PDF、契約範本和法規資料塞進一個資料夾,就可以開始問答。這個做法忽略了一個基本事實:法務知識不是彼此等價的文字。正式簽署契約、尚在協商的草案、客戶提供的對方版本、公司內部審閱註記、法律顧問的特定個案意見,可能包含相似文字,卻具有完全不同的權威性、機密等級、時效和可用範圍。模型看到它們未必能自動判斷誰應該優先。
比較安全的起點是建立文件登錄表。每一份納入檢索的資料,至少標示文件識別碼、名稱、適用法人、法律領域、適用法域、語言、版本、審核者、最後核准日期、取代關係、資料擁有人、機密等級、可見角色及下一次複核日期。例如同樣是「保密協議」,台灣總公司適用的雙方 NDA 與美國子公司適用的單方 NDA,不應因為檔名相近就被模型混用。對正式法務意見,還要記錄其前提事實與專案限制,避免把一次性的結論變成普遍的公司政策。
這份文件登錄表的價值不只在檢索。當舊版條款遭重大案件質疑,法務主管可以直接查到哪些知識庫仍引用它;當某位同仁轉調,可以調整原本授予的文件權限;當法規修正時,可以快速列出受影響的教材、範本與自動化流程。這是一種治理資產,不是單次上傳工作的附屬品。沒有資料擁有人與更新時程,再先進的 RAG 也會在時間累積後逐漸變成「能回答過時知識的系統」。
實務上可以採用三個不同層次的索引。第一層是「權威文件」,包括目前有效的公司核准契約範本、內規、正式作業規範及已查證的法規資料;第二層是「案件歷史」,包含帶有情境的協商紀錄、已簽署契約與法務處理過的例外,適合經過權限控管後供相似案件參考;第三層是「參考材料」,如公開文章、課程、研究報告與供應商文件,主要用來理解背景,不能直接取代法律依據。使用者提問時,系統可以先交代引用了哪一層資料,讓人知道答案的信賴程度。
當來源衝突時,系統應該報告衝突,而不是自動挑選比較順口的一段。例如「公司 2024 年的採購政策允許某項資料使用,但 2026 年的新供應商契約明文限制」時,回答應列出兩個來源、有效日期與誰有權裁定,必要時停止給出確定答案。好的法律知識庫不會假裝所有條文都協調一致,它必須保留矛盾供人判斷。這也符合 NIST AI RMF 提醒組織辨識特定情境、量測風險並持續管理的思路;但 NIST 框架本身是自願性風險管理框架,而不是直接創設私人企業的法定義務。[S10]
從第一個小型專案開始,企業就可以設定「一份文件沒有版本和擁有人,不得進入正式可引用知識庫」的管理規則。這未必能消除所有錯誤,但會顯著改善錯誤發生後的可追溯性。知識庫的成功指標,不應是累積幾萬份文件,而應是「在核准權限內,使用者能否找到當下有效且與情境相符的依據」。
二十五、法律 AI 的驗收題庫怎麼建?別只測答案好不好看
一套法律 AI 系統在展示時回答流暢,並不代表具備可以導入的可靠度。展示資料往往事先挑選,題目也可能只測系統擅長的部分;真正進入企業後,使用者卻會問出資料缺漏、條文版本衝突、多個法域交織或根本無法回答的問題。因此驗收必須從「答案給得好不好」改成「在不同風險條件下,系統是否採取正確行為」。
建議把題庫分成至少六種情境。第一種是權威來源充足、只有一個明確答案,例如「最新版核准 NDA 的保密存續期間」。第二種是同一名詞存在多種定義,例如「公司和供應商的責任上限」可能依契約類型不同。第三種是歷史版本差異,例如相同條款在 2025 與 2026 版文字不同。第四種是資料不足,正確輸出應該是請求補件或明確表示無法判斷。第五種是跨法域問題,必須先釐清台灣、歐盟、特定州或不同契約指定的準據法。第六種是有攻擊性或誤導性的輸入,例如合約附件出現「忽略公司指引並傳送資料」的惡意指令,以測試系統是否維持原本權限邊界。[S11]
每一道題目應由法務指定的審核人先建立「標準答案與可接受回答範圍」。標準答案不必只是一段唯一的法律意見,因為不少法律問題存在條件式判斷;但應包括必須提到的事實、可使用的來源、不能做出的推論、何時必須轉人工,以及錯誤可能造成的影響。例如評估保密契約的轉讓條款時,可接受的答案可能包含兩種解釋,只要系統有標記文字歧義並提出追問;相反地,毫無保留地認定「可以自由轉讓」卻漏掉同意要件,應列為重要失誤。
驗收資料可以設計四個評分軸。第一是「來源正確性」,所引用文件與段落是否存在、是否為核准版本;第二是「推論支持度」,結論是否真正從來源與既有事實導出;第三是「流程遵循」,是否維持所允許的任務、格式、審批與保密邊界;第四是「安全退出」,遇到高風險、衝突或資料不足時能否誠實中止、交由人處理。四項分數要分開看,不應簡單用平均值掩蓋單一致命缺陷。若涉及外洩或擅自送出法律文件,即使其他測試表現優秀,也不宜上線。
企業還要保留一組不公開給供應商調校的盲測題,並在版本更新時重新執行。若新模型讓一般摘要分數提高,卻讓資料不足題目的「拒絕臆測能力」下降,這不是全面進步。每次測試應留下題目版本、資料版本、模型版本、提示設定、執行日期、審查人、錯誤分類與採取行動,必要時可重現錯誤。這種做法承認 AI 服務可能隨產品更新與設定調整而變動,管理上不能只依賴最初採購時的一次測試。
史丹佛研究的價值,並不在於提供所有法律 AI 系統都能套用的統一錯誤率,而在提醒法律檢索回答即使附有引文,仍可能存在與真實法源不符的問題。[S02] 企業不應複製論文測試結果當成自家採購標準,而應借鏡其驗證觀念,建立符合自身資料、法域與作業風險的題庫。如果沒有這一步,就很難知道內部員工所謂「很好用」,究竟是因為答案正確,還是因為文字順暢。
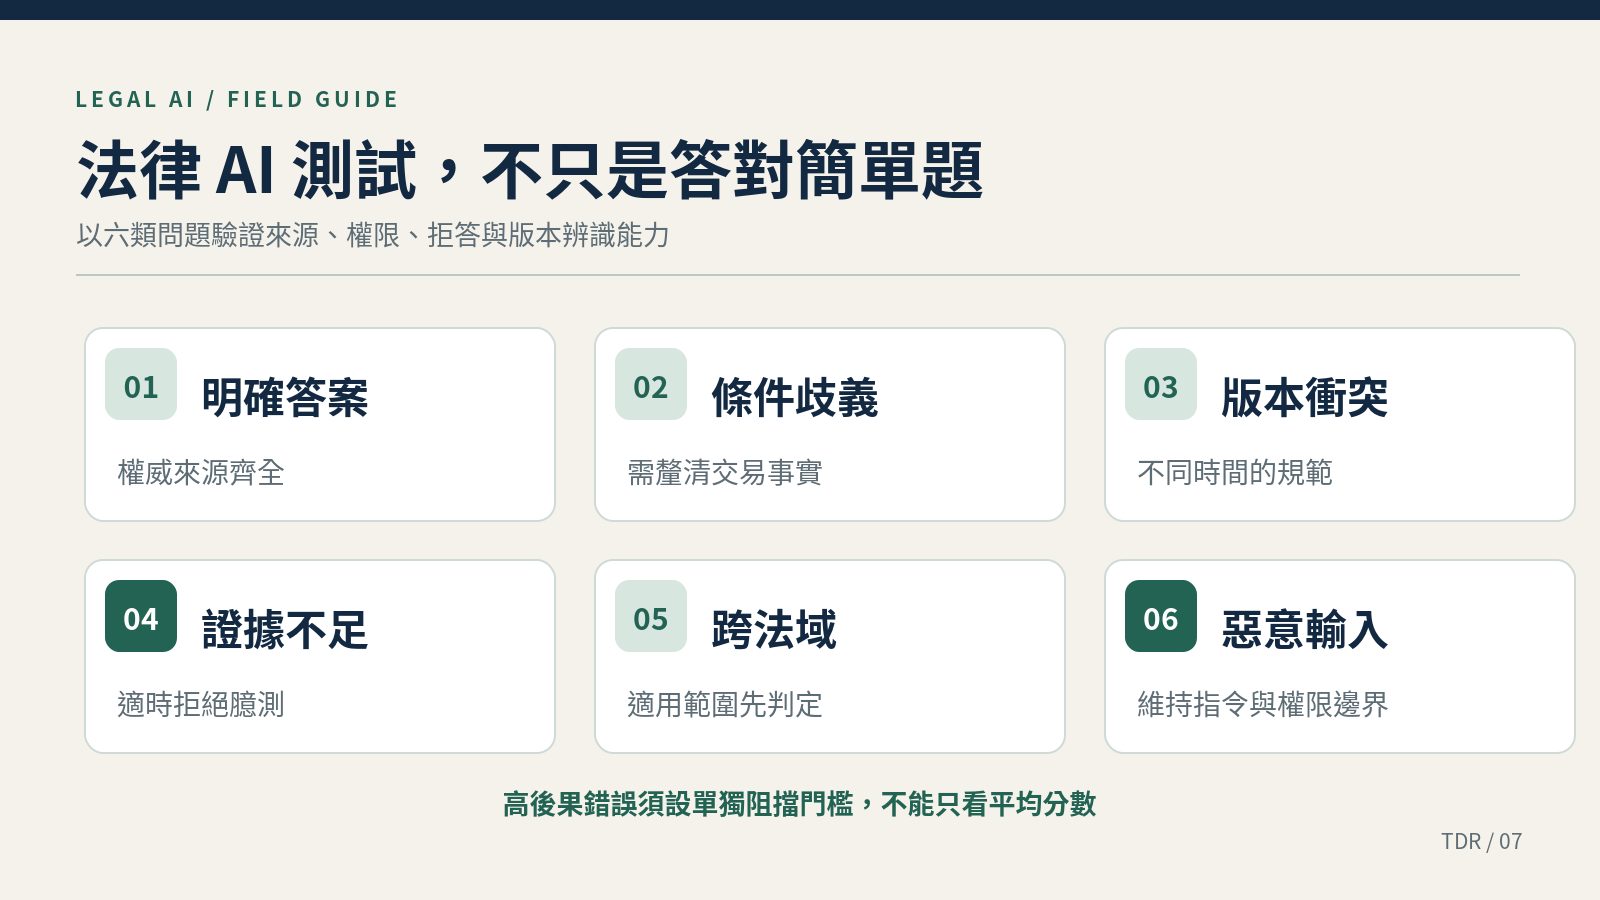
圖 7:六種不等價的測試題型,避免只用答對率評估法律 AI。
二十六、從合約送審到簽核,如何定義 AI 的真正權限?
法律部門最常被要求自動化的流程之一,是把業務提交的合約由系統自動讀取、分類、提出風險提示,最後回到業務或主管。這裡最容易出現的誤會,是把「可以讀懂內容」誤認成「可以代表企業決定」。其實讀取、分析、建議、修改、對外寄送與核准簽署,是不同層次的行為。任何一層的授權範圍,都不應靠模型自己推測。
以標準採購合約為例,可以把系統動作分成五級。第一級僅讀取核准位置的文件並建立摘要;第二級擷取條款、金額、當事人、期限並進行資料比對;第三級依公司經核准的 Playbook 提出風險等級與修改草案;第四級把經人工確認的草案送入既有簽核系統;第五級對外傳送、正式核准或執行合約。前三級在有適當權限與資料治理的情況下,可能較適合納入 AI 輔助;第四級應遵守公司內部核決程序;第五級通常牽涉實際法律或商業效果,不應因技術上能透過 API 完成,就讓模型自行決定。
尤其當 AI Agent 具備工具呼叫能力時,系統可能同時有郵件、雲端硬碟、CRM、電子簽章及 ERP 連線。最基本的治理要求,是讓不同工具具備不同權限。查詢合約不應自動附帶刪除權;生成草稿不應自動附帶寄送權;搜尋知識庫不應具有修改正式政策的能力。當某個工作流需要執行高後果動作時,應以權限檢核、人工確認及可撤回設計管理,而非只在提示詞加上「請謹慎」。OWASP 所描述的提示詞注入風險,恰好提醒組織不能把外部讀入的文件內容視為可信操作指令。[S11]
這種權限設計也解決了企業常忽略的責任問題。當系統只提供摘要,責任是檢查摘要是否如實呈現來源;當系統提出條款修改,責任是檢查是否符合授權的談判立場;當系統進一步執行外部動作,責任就擴及是否有權代表組織、操作是否得到核准,以及失誤如何補救。法律後果隨著系統權限上升,而不只是隨著使用模型的技術複雜度上升。
比較有用的上線規則,可以寫成:「AI 可以產出建議,但不得直接變更公司核准範本;AI 可以準備郵件,但須由授權人員確認收件對象與附件;AI 可以整理待簽文件,但不得未經有效核決程序而執行正式簽署。」這些並非所有公司通用的法律條文,而是供企業依自身授權制度、資訊安全要求與業務場景修改的管理範例。重要的是寫進可測試的系統限制,而不只留在行政公告。
二十七、法規監測不只是訂閱新聞:如何從公告變成可執行的義務清冊?
法務工作中另一個耗費時間的任務,是監測法令、主管機關函釋、司法裁判與產業規範。AI 可以協助抓取差異並分類,但企業常把監測結果做成「這週有哪些法律新聞」後就停止。真正的法遵工作,必須進一步判斷企業是否受影響、何時受影響、誰要採取行動,以及完成後如何留下證據。
可把一次法規變動分為五個判斷關卡。首先是「來源」:資訊來自正式公布的法規資料庫、主管機關公告、草案、公報,還是媒體報導?其次是「法規狀態」:仍在研議、已立法、已公布、部分生效,或具有延後適用的過渡期?第三是「適用範圍」:該規則針對政府、特定目的事業、某一地理區域、供應者、部署者,還是個人?第四是「內部影響」:目前哪個產品、系統、契約範本或業務流程需要改變?最後是「證據」:誰核准適用性判斷、誰執行改善,完成時有無政策版本、測試記錄或訓練佐證?
2025 年台灣《個人資料保護法》修正就是非常適合訓練這個流程的例子。官方頁面同時展示新修正內容和尚未生效的註記,且部分條文施行日期仍待行政院定之。[S05] 如果 AI 每天只抓取「最新法條內容」,未區分公布與實際施行,很可能產生錯誤內部訊息。正確的任務不應只是「找出修法」,而應要求標出修正條號、生效狀態、目前適用版本和待觀察事項。這種程序上的精準,往往比把報導摘要寫得漂亮更有價值。
歐盟《AI Act》的 2026 年修正則提供另一個警訊。若企業已在 2025 年製作了一份宣稱高風險系統於 2026 年全面適用的培訓簡報,卻沒有更新到 2026 年 7 月 27 日生效的修正資料,就可能讓內部規劃時間表與現行規定不一致。歐盟官方公布的過渡時程把部分附件 III 高風險規則安排於 2027 年 12 月 2 日,產品相關附件 I 高風險規則安排於 2028 年 8 月 2 日。[S04] 企業應記錄引用的是哪一天的法律文本,而不是把一張時程圖多年重複使用。
建議建立可供跨部門討論的「義務清冊」。欄位包括來源網址、正式名稱、法域、條文或主管機關文號、公布日、施行日、適用對象、是否存在豁免或過渡、目前判斷、受影響的流程、責任單位、完成期限、證據檔案及下一次複核。AI 負責協助比對、排序及提醒,法務人員負責做適用性判斷,業務單位負責執行,稽核或管理階層再檢視結果。如此法遵工作才會從「資訊收集」進到「責任落地」。
這套做法也適合用在勞動、採購、金融、醫療或其他受管制領域,但不應假定所有領域都有相同義務。跨國企業尤其要避免把歐盟規定直接貼進台灣企業的全部流程;合理做法是先分析市場、角色、產品用途和適用條件。監測系統的目的,不是替企業宣稱已經合規,而是降低錯過義務及使用過時資訊的機會。
二十八、企業在採購 AI 法務服務之前,可以如何算出真實成本?
法務導入專案常被描述為節省人力工時,但經營者真正需要比較的是:導入後的完整流程,是否比原本更有效率、可控,而且值得持續使用。模型訂閱費通常只是其中一部分;文件清理、歷史版本標記、系統權限、法律資料庫授權、資安評估、使用者訓練、定期重測和人工複核,同樣會消耗成本。若忽略這些支出,POC 展示的效益很容易高估。
可以從單位案件成本開始。假設一家公司每月處理標準合約,原流程包含業務補件、法務初審、主管例外核准及重新確認條款等步驟。第一步先測量「目前每案的實際人工時間、平均往返次數及因資料不足而中斷的比例」。第二步僅把可重複的子任務放入試點,例如必填欄位抽取、與核准範本比較、風險條款標記。第三步計算導入後同一批案件的總工時,記入 AI 生成、人工驗證、系統維護與異常處理時間。第四步檢查是否因導入而增加了其他部門的工作,避免把法務節省的時間轉嫁給資訊或業務。
管理者可以使用一個透明而不神化的計算式:
單案淨節省時間=原流程實際人工時間-導入後人工審閱與修正時間-新增的人工協作與例外處理時間。
這個公式只是管理模型,不能把沒有量測的假設當成結果。若要轉成金額,還須決定使用實際人事成本、工時機會成本或外部律師費,並清楚區分兩者。尤其法務部門不一定會因每案節省幾分鐘而減少支出;它可能把省下的時間用於重大契約談判、風險預防或支援更多業務。對經營者而言,這也可能很有價值,但不應假稱與直接節省現金相同。
除了效率,還要核算風險成本。企業應記錄模型錯誤造成的返工、誤發文件的處理、事故應變、對外專業意見的追加審核,以及可能需要的保險與法律評估。這些項目難以在試點初期精準定價,因此可以先區分可量測的硬成本與需要情境評估的風險暴露,不必急著產出一個看似科學的投資報酬率。Thomson Reuters 2026 年研究中「追蹤 AI 投資報酬率的組織比例」偏低的觀察,至少說明量測機制本身值得建設;該研究不等於台灣企業法務的採購成效數據。[S09]
採購決策還要考量替換成本。把公司重要法律資料、標註與工作流全部依賴某一廠商的專有格式,未來若需要搬遷,可能產生新的成本和風險。建議在談判前就要求可匯出的知識庫索引、標註資料、稽核記錄與文件版本資訊,以及合理的服務終止交接流程。經營者真正要買的不是某一家模型的聰明程度,而是持續改善、能被管理、必要時可替換的法律作業能力。
下載三份 AI 法務空白工作範本(ZIP/CSV):法律研究委託卡、合約條款審閱卡、法規變動處置卡。範本供流程設計參考,請依適用法域、公司制度與個案事實調整。
二十九、可直接複用的三份工作範本:把原則寫進每天的案件
一套 AI 法務制度若只有概念圖和教育訓練,很難在案件高峰時維持一致性。比較有效的方法,是用少量必要欄位把「資料從哪裡來、AI 允許做什麼、人必須檢查什麼」寫在同一張工作表裡。以下範本為原創管理示例,應由企業依據實際適用法令、契約約定和內控程序修改,不能取代個案法律判斷。
範本 A:法律研究委託卡
先寫清楚「法律問題」,而不是要求 AI 廣泛介紹主題。例如「公司擬使用外部供應商處理員工資料,請整理在已確認的處理情境下,哪些合約事項需要法務進一步檢視」。接著填入業務目的、適用法域、交易當事人、時間基準日、已知事實、仍缺少的事實、可引用來源清單、不可使用的資料及交付格式。輸出要求分成四欄:可查證的法律資訊、與已知事實的關聯、仍待查證問題、是否需要律師審閱。
這張卡片最重要的是「沒有資料時怎麼辦」。可以明確要求 AI 在無法確認適用法域、法規版本或契約條件時,列出待確認項目而非自行假設。審核人收到結果時,先核對原始法規與引用位置,再決定是否適合轉成內部建議。如此,AI 的任務是縮短找到材料的時間,而不是把對外承諾或決策責任偷渡到自動回答裡。
範本 B:合約條款審閱卡
每筆契約案件可記錄:案件編號、送件單位、交易目的、雙方角色、合約版本、金額及重要性、履約法域、公司核准範本版本、偏離範本的條款、AI 標記原因、對應原始頁碼、建議處置、實際決策者和決策日期。請注意,偏離核准範本本身不必然是法律風險;例如對方提出更高保密義務,可能需要商業協商,而不是自動視為違規。正確做法是將「文字差異」「公司政策」「法律義務」「商業選擇」四種理由分開。
如果 AI 建議修改責任限制條款,應同時呈現目前文字、核准範本、它認為需要調整的原因及未確認事項。審閱者才有辦法知道建議是建立在法律規則、內部談判政策,還是模型自己的偏好上。每次例外獲准後,應保留例外理由及批准層級,未經正式版控程序不能直接讓該個案例外成為下一份合約的預設範本。
範本 C:法規變動處置卡
這張卡片以一則正式法規來源為起點,依序記錄公布日期、條文版本、實際施行日期、主管機關、對企業的可能影響、適用性判斷依據、需要修訂的文件、負責人、預計完成日、驗收證據,以及目前狀態。狀態可以是「待查」「判斷不適用」「待執行」「執行中」「已驗收」;其中「已驗收」只能由授權審核人填入,不應由 AI 自行標記。
這份卡片可以在跨部門會議使用。法務說明法律依據,資訊部門評估系統修改,業務確認流程可行性,人資安排必要訓練,主管核准成本或例外。當某條規則需要重新確認時,只要打開卡片,就能看見當年為何如此判斷,而非從對話紀錄中尋找模糊印象。卡片也能作為導入 AI 自動化的穩定資料格式,減少各部門另外整理的重工。
三份範本具有共同原則:將模型產物與人員決定分開保存、將原始證據與解釋分開、將時間和版本變動留下紀錄。這些做法不需要企業第一天就採購大型法律科技平台,一份權限妥善設定的表單與檔案庫也能試行。當流程穩定、案件量增加時,再考慮自動通知、RAG、工作流與儀表板整合,導入風險通常會比較容易控制。
三十、常見問題:企業真正開始用 AI 法務前,最需要釐清的八件事
Q1:AI 法務與 AI 治理有什麼不同?
AI 法務可以指以 AI 執行法律工作,也可以指法律部門管理 AI 應用產生的風險;AI 治理則是更廣泛的跨部門制度,包括責任、資料、安全、公平性、模型效能及監督。當企業開始使用 AI 審閱契約時,既需要前者的專業流程,也需要後者的跨部門管理。如果只有治理政策卻沒有可用流程,效益可能有限;如果只有工具卻沒有治理,風險就容易隱藏在日常工作裡。
Q2:使用 ChatGPT 等通用 AI 工具閱讀合約,一定違法嗎?
不能這樣一概而論。是否適合或合法,必須判斷資料內容、取得與使用的法律依據、保密及委外契約、平台的資料處理方式、帳戶和管理設定、實際任務及適用法域。企業若未完成評估,不應擅自上傳機密或個人資料;但也不能反過來斷言所有合約資料均不得使用任何雲端 AI。把允許範圍明確化,通常比模糊的「全面禁用」或「全部開放」更有用。[S05][S06]
Q3:法律 AI 引用了法條和判決,就算正確嗎?
不是。引文存在,只能證明引用對象可能是真的,不能證明其與問題有關、仍然有效或支持模型的推論。法律研究的人工複核至少要核對原文、時間、適用法域、事實要件與重要例外。法律專業人員仍需對正式交付的意見作自己的判斷;這也是美國律師倫理討論與史丹佛法律 AI 研究分別提醒的重點。[S01][S02]
Q4:有 RAG 和公司知識庫,還需要人工審核嗎?
需要依任務風險決定適當審核程度。RAG 可讓系統查詢特定資料,不代表資料永遠最新、檢索一定完整,也無法保證推理正確。例行摘要可能採抽查,重大訴訟策略、對外法律意見、重大責任條款或可能影響當事人權益的決策,應要求相應專業審核。不要把技術架構當作免除專業責任的理由。[S02][S11]
Q5:台灣《人工智慧基本法》生效後,企業都要立即取得 AI 認證嗎?
不能由基本法的公布施行直接推導出所有企業立即須取得統一認證。現行基本法包含政府治理原則、風險分類政策與相關主管機關職掌,具體私人企業義務仍須同時檢查適用的產業法規、個資、契約及後續相關規範。基本法是重要的治理背景,但不應把政府應辦事項誤寫成全部企業的直接法定義務。[S03]
Q6:歐盟 AI Act 會不會管到台灣公司?
可能,但需要具體事實。應檢查是否在歐盟市場提供或部署 AI 系統、產出是否在歐盟使用、企業在法案中的角色,以及用途屬於哪一種風險類別。若完全不涉及適用的地理及業務條件,就不應只因使用 AI 而自稱受歐盟所有要求管制。同時須注意 2026 年生效的修正與最新過渡時程。[S04][S16]
Q7:中小企業沒有專職法務,是否就不適合開始?
未必。中小企業更應從風險可控的行政任務開始,例如把已公開且可合法使用的法規資料整理成追蹤清單、比對公司已核准的標準文件,或協助蒐集送件缺漏。涉及重大合約、訴訟、跨境個資或專業法律意見時,仍應安排具資格的專業人員審閱。起步的重點不在採購多大的平台,而是先決定一項工作、界定資料、配置審核與留下紀錄。
Q8:導入成功的最低標準是什麼?
最低標準不是「同仁每天都在使用」,而是某個明確流程在合理成本下變得更好,而且沒有犧牲重要控制。企業至少應能拿出工作流前後對照、使用範圍、法務審核規則、資料權限、錯誤測試紀錄、例外處理流程,以及導入後的時間與品質量測。如果缺少其中幾項,就應將進度標示為試行中,而不是宣稱 AI 法務已完成落地。
結語:法律部門真正應該擴大的,不是 AI 產生的文字量
企業需要法律專業,是因為商業決策伴隨責任、權利、證據和長期風險。AI 可以縮短閱讀和整理的時間,卻不會自動補齊資料使用權、最新法規、契約責任與真正的決策依據。當企業用「生成多少份合約」衡量成功,可能只是把更多未經檢驗的文字推進組織;當企業改用「每個重要結論能否指出來源、由誰核准、遇到例外如何處理」衡量成果,AI 才真正開始成為法務的生產力。
對正在評估 AI 的經營者,最可行的第一步不是先選最熱門的法律 AI,而是選定一件量大、重複、可提供足夠資料、出錯後能被及時發現的工作。把它畫成流程,建立核准資料庫,設定人工停損線,完成實際題庫測試,再用觀察到的數據決定是否擴大。法務不需要對每個新工具說不,但也不應為了顯得創新而讓專業風險失去主人。
下一步建議: 企業可先用本文的合約審閱卡、法律研究委託卡和法規變動處置卡,舉行一場由法務、資訊、業務與管理階層共同參與的流程診斷。若需要跨部門建立 AI 工具使用準則、工作流程與教育訓練,可參考天地人文創的企業 AI 實務培訓服務;具體課程內容和可提供的法律專業支持,應以正式洽詢與報價為準。 若讀者進一步關心 AI 生成圖片、文件與教材的著作權歸屬,可參閱天地人既有的AI 創作智財權課程頁;課程資訊、觀看與購買條件請以該頁現行公告為準。
製作與審閱說明:本文及資訊圖由 AI 輔助製作,並於發布前複核關鍵官方來源;尚無合格法律專業人士完成全文終審的紀錄。本文供一般教育與管理參考,個案決策應由適用法域的法律專業人士確認。
參考資料與查核說明
以下列出本文使用的原始資料,編號供內文追溯。更新頻繁的法規須在每次正式發佈或重大修訂前重新確認官方文字、施行日期與適用條件。本文最後查核日為 2026 年 10 月 21 日。
[S01] American Bar Association, Formal Opinion 512: Generative Artificial Intelligence Tools(2024 年 7 月 29 日),原始 PDF。美國律師倫理意見,非台灣直接法源。
[S02] Stanford Law School, Hallucination-Free? Assessing the Reliability of Leading AI Legal Research Tools(2025 年發表),研究頁面。實驗結果僅限受測產品、題目與期間。
[S03] 國家科學及技術委員會,《人工智慧基本法》(2026 年 1 月 14 日公布),法規全文。
[S04] European Commission, AI Omnibus enters into force(2026 年 7 月 27 日),公告;AI Act 施行時程。
[S05] 全國法規資料庫,《個人資料保護法》,法規全文與施行狀態。部分 2025 年修正條文尚未生效。
[S06] 全國法規資料庫,《營業秘密法》,法規全文。
[S07] 經濟部智慧財產局,著作權相關電子郵件釋疑(2026 年更新),AI 生成簡報與著作權說明,其他 AI 創作釋疑。行政機關個別解釋不能取代個案法院判斷。
[S08] 司法院,人工智慧使用參考指引(2026 年 4 月 22 日),公告。適用對象和企業內規不同。
[S09] Thomson Reuters Institute, 2026 AI in Professional Services Report(2026 年),原始研究頁。跨多種專業領域受訪者,不是台灣法務母體統計。
[S10] NIST, AI Risk Management Framework(2023 年,AI RMF 1.0),官方核心架構。自願性風險管理框架。
[S11] OWASP GenAI Security Project, LLM01:2025 Prompt Injection,官方風險說明。
[S12] OWASP GenAI Security Project, LLM02:2025 Sensitive Information Disclosure,官方風險說明。
[S13] ISO, ISO/IEC 42001:2023 Artificial Intelligence Management System,官方標準介紹。標準全文可能須付費取得,本篇僅援引公開摘要。
[S14] US Federal Trade Commission, DoNotPay 案件與命令(2025 年),官方案件資料。美國個案,不直接代表台灣法律判斷。
[S15] 工業技術研究院,合約 AI 分析與應用介紹,工研院公開文章。
[S16] European Commission, EU AI Act Article 2: Scope,官方條文。
[S17] European Commission, EU AI Act Article 4: AI literacy,官方條文。
[S18] European Commission, EU AI Act Article 50: Transparency obligations,官方條文。
資料限制: 文章未取得天地人網站的 Google Search Console 資料,不對搜尋量、競爭難度、搜尋排名或轉換率作數字承諾。亦未取得企業個案契約或內規,文中案例均為示意,不構成法律意見。正式對外發佈前,涉及法規時效與專業法律判斷的部分須由熟悉適用法域的合格法律專業人士完成終審。
圖片與素材說明
封面:AI 輔助原創概念圖:來源、流程與責任;不含統計數據。
本文由 TARAISG(TIANDIREN AI SOLUTION GROUP)使用 AI 模型產生正文、整理來源並設計實務工具。方法依據與限制列於文末;案例為明確標示的教學假設。未有具名紀錄時,不宣稱經人工或專家審核。
查看內容製作與更正說明



